La maggior parte delle dimostrazioni sui large language model segue sempre lo stesso schema: si dà un prompt al modello e si aspetta che generi testo.
Ma la generazione di testo è solo uno dei modi in cui si può usare un modello linguistico.
Un modello piccolo può anche essere addestrato o adattato per osservare uno stato, valutare un insieme limitato di azioni possibili e sceglierne una. In questo ruolo, il modello smette di somigliare a un chatbot e comincia a somigliare a un motore decisionale.
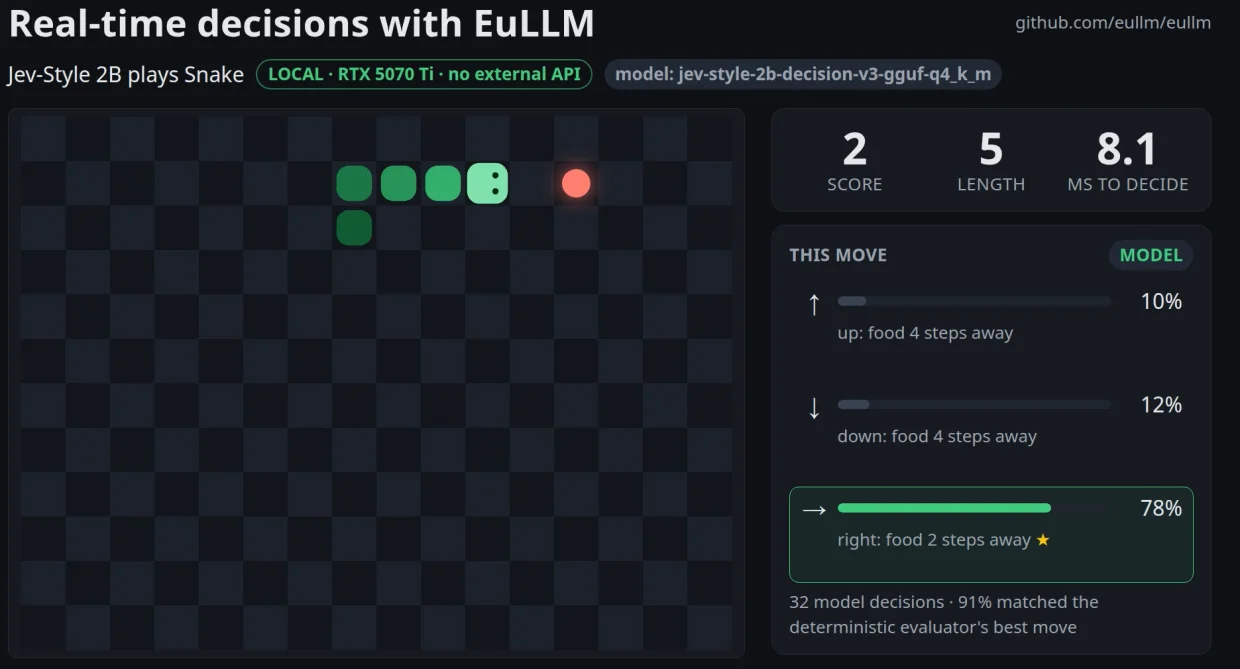
Abbiamo costruito una dimostrazione semplice di questa idea usando un Decision Model Jev-style da 2B in esecuzione locale con EuLLM.
Il task è volutamente familiare: Snake.
La parte interessante non è il gioco. È quello che succede tra una mossa e l'altra.
Una decisione in circa 8 millisecondi
A ogni passo, il modello riceve lo stato attuale del gioco e valuta le azioni disponibili.
Non deve scrivere un saggio né produrre centinaia di token. Deve rispondere a una domanda molto più circoscritta: cosa devo fare adesso?
Su una NVIDIA RTX 5070 Ti, il modello nel nostro test prende quella decisione in circa 8 millisecondi.
L'intera inferenza gira in locale tramite EuLLM. Nessuna chiamata verso un provider di modelli esterno, nessuna API remota coinvolta nel ciclo decisionale.
La demo include anche un evaluator deterministico che calcola in modo indipendente la migliore azione disponibile a partire dallo stato corrente.
Su oltre mille decisioni durante un'esecuzione, circa il 95% delle scelte del modello ha coinciso con la mossa migliore individuata dall'evaluator.
Questa distinzione è importante. Il 95% non è un generico "punteggio di accuratezza" e non è un LLM-giudice che valuta un altro LLM. Misura l'accordo tra la decisione del modello e un'implementazione di riferimento deterministica per questo task specifico.
Perché usare un LLM per prendere decisioni?
Una domanda naturale è perché qualcuno dovrebbe usare un modello linguistico per un task risolvibile con codice tradizionale.
Per Snake in sé, non c'è una ragione convincente. Snake è semplicemente un ambiente visivo in cui chiunque può capire immediatamente se una decisione era buona o cattiva.
Le applicazioni interessanti iniziano quando lo stato è più difficile da rappresentare con un insieme fisso di regole.
Immagina un agente enterprise che ha recuperato dei documenti, esaminato una richiesta di un cliente e chiamato due tool. Ora deve stabilire se rispondere, recuperare altre prove, invocare un altro tool o escalare il task a un umano. Questo è un problema decisionale.
Un sistema di sicurezza potrebbe dover decidere se un evento va ignorato, correlato con l'attività precedente, indagato o escalato.
Una pipeline RAG potrebbe dover decidere se le prove attualmente recuperate sono sufficienti per rispondere a una domanda.
Un sistema industriale potrebbe dover selezionare l'azione successiva a partire da telemetria, condizioni operative e istruzioni testuali.
In ognuno di questi casi, l'output può essere estremamente piccolo anche quando l'input è complesso. Questo cambia l'economia dell'inferenza.
I modelli piccoli non devono sempre comportarsi come piccoli chatbot
Il settore tende a valutare i modelli piccoli chiedendosi quanto bene riescano a imitare modelli general-purpose molto più grandi. È utile, ma non è l'unico modo di usarli.
Un modello piccolo può invece essere specializzato attorno a uno spazio decisionale ristretto. Se l'output richiesto è un'azione tra cinque possibili, generare diversi paragrafi di linguaggio naturale è overhead inutile.
Questo è particolarmente rilevante per l'AI locale. Un modello da 2B è abbastanza piccolo da girare su hardware ampiamente disponibile, restando comunque abbastanza grande da interpretare input molto più ricchi rispetto a un classificatore tradizionale.
Il confronto utile quindi non è sempre modello piccolo contro modello grande, ma a volte modello specializzato contro inferenza general-purpose remota per ogni singola decisione.
Per applicazioni che prendono centinaia o migliaia di decisioni, latenza e requisiti infrastrutturali diventano rapidamente significativi.
Dove si inserisce EuLLM
EuLLM non è un modello. È una piattaforma open pensata attorno all'infrastruttura AI locale ed europea.
Il progetto è composto da tre parti complementari.
EuLLM Engine fornisce il runtime usato per eseguire i modelli in locale.
EuLLM Forge si concentra sulla specializzazione dei modelli, la verticalizzazione e i workflow teacher-student.
EuLLM Hub è in sviluppo come registro europeo di modelli e livello di distribuzione, incluse le informazioni su modello e conformità.
L'esperimento con Snake riguarda principalmente il lato Engine: un piccolo modello decisionale quantizzato in esecuzione locale che risponde con latenza molto bassa.
Ma la combinazione a lungo termine è più interessante. Un modello teacher più grande può aiutare a produrre modelli specializzati più piccoli tramite Forge. Quei modelli possono poi essere eseguiti da Engine vicino alle applicazioni che li usano.
Questo è particolarmente interessante quando l'inferenza deve restare privata, prevedibile ed economica.
Modelli decisionali e agenti AI
Una delle applicazioni più ovvie è l'AI agentica.
Gli agenti di oggi mandano spesso decisioni di controllo relativamente semplici a modelli remoti di grandi dimensioni:
- L'agente deve cercare di nuovo?
- Quale tool deve chiamare?
- Le prove attuali rispondono alla domanda dell'utente?
- Il task va escalato?
Queste decisioni richiedono spesso di comprendere il contesto, ma non richiedono necessariamente un modello generativo molto grande.
Un piccolo modello decisionale locale può potenzialmente far parte del control plane, lasciando l'inferenza generativa costosa alle situazioni in cui è davvero necessaria.
La stessa architettura può essere applicata alle pipeline RAG. Il retrieval non deve essere per forza una sequenza fissa di ricerca, reranking e generazione. Un modello può esaminare la qualità del retrieval e stabilire se un'altra ricerca è giustificata, se va interrogata un'altra fonte o se la confidenza è sufficiente per proseguire.
Anche qui, l'output è una decisione, non un documento.
L'esecuzione locale cambia il budget di latenza
Una decisione in 8 ms non è importante solo perché è un numero piccolo. Cambia quali applicazioni sono praticabili.
Se ogni passo di un workflow automatizzato richiede una richiesta HTTP remota verso un servizio di inferenza esterno, la latenza si accumula. Variabilità di rete e disponibilità del servizio diventano parte del ciclo di controllo.
L'inferenza locale elimina quel round trip. Significa anche che l'informazione sottostante non deve lasciare la macchina che esegue l'applicazione.
Per gli ambienti enterprise, queste proprietà possono essere rilevanti quanto la qualità del modello stesso.
Snake è la visualizzazione, non l'obiettivo
Abbiamo scelto Snake perché il ciclo decisionale è visibile. Puoi guardare il modello esaminare lo stato, scegliere un'azione e vederne immediatamente la conseguenza.
Lo stesso meccanismo diventa meno spettacolare da vedere — ma potenzialmente molto più prezioso — quando le azioni sono cose come:
retrieve_morecall_toolapproveescalateroute_to_departmentinvestigate_eventcontinue_workflow
È lì che i piccoli modelli decisionali diventano interessanti.
L'esperimento suggerisce una direzione più ampia per EuLLM: l'infrastruttura AI locale non deve per forza essere pensata solo attorno al completamento di chat.
A volte l'output più utile che un LLM può produrre non è una frase.
È l'azione successiva.
EuLLM è open source: github.com/eullm/eullm
Progetto: eullm.eu