Vor zwei Wochen loggten wir uns in zwei Terminals ein, die sich von unseren üblichen Entwicklungsmaschinen sehr unterschieden. Eines begrüßte uns mit einem ASCII-Art-Banner „LEONARDO“ und einer SLURM-Warteschlange. Das andere, ein „LUMI“ in Pixel-Block-Buchstaben, bezeichnete sich als „The Supercomputer of the North.“
Beide sind Systeme des EuroHPC Joint Undertaking. Beide gehören zu den leistungsfähigsten Computern des Kontinents. Und beide sind nun Teil davon, wie wir EULLM bauen.
Was wir bekommen haben
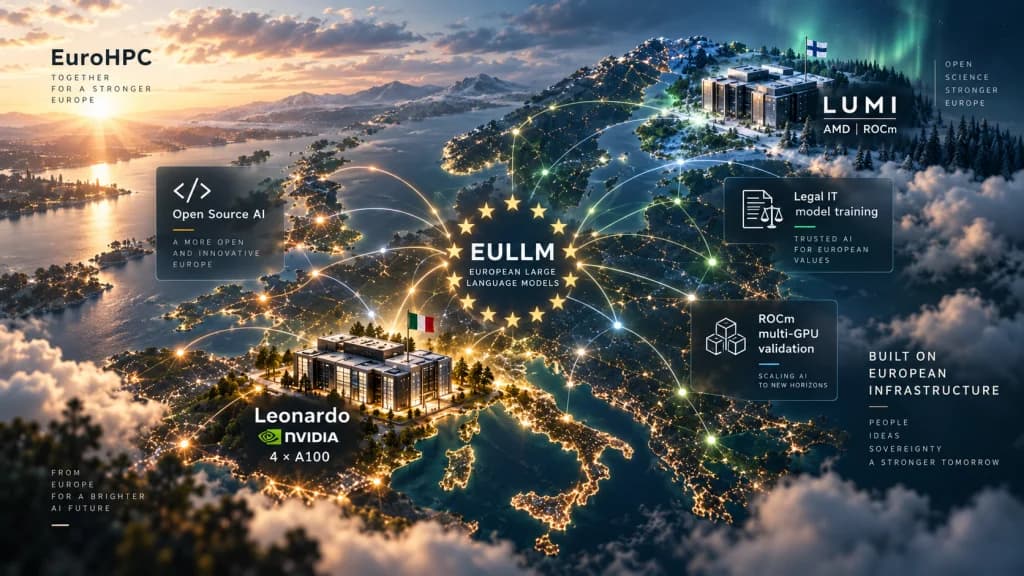
Leonardo ist am Cineca in Bologna, Italien, untergebracht. Das Booster-Modul, auf das wir Zugriff haben, umfasst 3.456 Rechenknoten, jeder mit 32 Ice-Lake-Kernen bei 2,60 GHz, 512 GB RAM und vier NVIDIA Ampere A100 GPUs mit 64 GB VRAM. Die Verbindung ist 200G HDR Infiniband Dragonfly+. Kurz gesagt: eine ernsthafte Maschine.
LUMI ist am CSC in Kajaani, Finnland, untergebracht. Es nennt sich „The Supercomputer of the North“ — und die Zahlen rechtfertigen den Titel. Entscheidend für uns: LUMIs GPU-Partition ist vollständig auf AMD-Hardware aufgebaut — was ROCm bedeutet, nicht CUDA.
Was wir auf Leonardo machen
Die Hauptarbeit auf Leonardo ist unser erstes vertikales Modell: Legal IT.
Das Ziel ist ein 7B-Spezialist, trainiert auf kuratierter italienischer Rechtsprechung, dem Zivilgesetzbuch und dem EU-Regulierungskorpus — ein Modell, das Verträge, GDPR-Bewertungen und EU-Compliance-Fragen auf eine Weise versteht, die ein allgemeiner 70B-Generalist nicht kann. Nicht weil es größer ist, sondern weil jeder Parameter relevant ist.
Die Pipeline: ein Frontier-70B-Open-Weight-Modell als Lehrer, Structural Pruning zur Entfernung für das Rechtsdenken irrelevanter Kapazität, Knowledge Distillation in den 7B-Schüler, Quantisierung für Inferenzeffizienz und Identity Fine-Tuning für Persona und Anweisungen. Die Forge-Pipeline, kurz gesagt, auf echtem Eisen.
Bevor wir mit dem Training begannen, wollten wir verifizieren, dass EULLM Engine die Hardware tatsächlich ansteuern kann. Wir haben daher ein 27B-Modell über alle vier A100s eines einzelnen Knotens laufen lassen. Es hat funktioniert. Der Multi-GPU-Inferenzpfad — CUDA-basiert, mit EULLMs eigenem Batching und Speicherverwaltung — hat ein 27B GGUF problemlos verarbeitet, mit den erwarteten Durchsatzgewinnen durch die Verteilung der Modellgewichte auf vier 64-GB-Karten.
Das ist ein bedeutsamer Datenpunkt. Er sagt uns: Wenn Legal IT 7B verfügbar ist, kann eine europäische Organisation mit einem einzigen 4×A100-Knoten (on-premise oder Cloud) es komfortabel betreiben — mit Spielraum für gleichzeitige Nutzer.
Was wir auf LUMI machen
LUMI ist eine andere Herausforderung. LUMIs GPU-Partition verwendet AMD Instinct Beschleuniger, was bedeutet: der relevante Stack ist ROCm, nicht CUDA.
Das ist wichtiger, als es scheinen mag. „Läuft auf GPU“ ist kein Monolith. Code, der auf NVIDIA-Karten perfekt funktioniert, kompiliert möglicherweise nicht, stürzt ab oder läuft mit schlechter Performance auf AMD-Hardware. EULLM Engine liefert bereits ROCm-Unterstützung — wir haben es in den Release Notes als experimentell gekennzeichnet — aber experimentell ist nicht validiert.
LUMI ist der Ort, wo wir es ordentlich validieren. Das Ziel: EULLMs Inferenz-Stack über mehrere AMD-GPUs laufen lassen und bestätigen, dass Durchsatz, Korrektheit und Stabilität unter echter Last halten. Wir verwenden dieselben Modellgewichte, dieselbe API-Oberfläche, auf radikal anderer Hardware.
Warum ist das für europäische KI-Souveränität wichtig? Weil Hardware-Lock-in eine Form von Abhängigkeit ist. Wenn EULLM nur zuverlässig auf NVIDIA funktioniert, bleiben europäische Organisationen, die AMD-Infrastruktur betreiben — und es gibt erhebliche AMD-Deployments in europäischen HPC- und Forschungsnetzwerken — außen vor. LUMI gibt uns eine echte Multi-GPU-AMD-Umgebung statt eines Simulators oder einer Einzelkarten-Testmaschine.
Warum EuroHPC
Wir hätten GPU-Zeit von einem US-Hyperscaler mieten können. Haben wir nicht.
EuroHPC-Systeme sind europäische öffentliche Infrastruktur. Die Daten, auf denen wir rechnen, verbleiben in europäischer Rechtshoheit. Der Vergabeprozess ist wettbewerbsbasiert und leistungsorientiert — man reicht eine Projektbeschreibung ein, erklärt, was man baut und warum es die Rechenleistung benötigt, und ein Ausschuss entscheidet. Wir finden es richtig, einen europäischen souveränen KI-Stack auf europäischem souveränem Compute zu bauen.
Es gibt auch ein praktisches Argument: Die Hardware bei Leonardo und LUMI ist schlicht exzellent. Vier A100-64-GB-Karten pro Knoten lassen sich auf Spot-Instanzen nicht leicht replizieren. LUMIs Skalierung von AMD-GPUs ist in Europa schlicht nirgendwo zum Mieten verfügbar.
Was als nächstes kommt
Legal IT ist eine Pipeline in Arbeit. Die Dataset-Kuration ist fast abgeschlossen. Die Pruning- und Distillation-Läufe werden in den nächsten Wochen auf Leonardo stattfinden. Wenn das 7B-Modell unsere internen Qualitätsschwellen passiert — und die AI-Act-Konformitätskarte ausgearbeitet ist — kommt es in den Hub.
Für LUMI: ROCm-Multi-GPU-Validierungsläufe laufen. Wir werden eine technische Notiz mit Benchmarks veröffentlichen, wenn die Ergebnisse solide genug sind, um dahinterzustehen.
Wenn Sie auf europäischer Infrastruktur bauen und wissen möchten, wann Legal IT verfügbar ist, folgen Sie am besten unserem GitHub. Issues, Diskussionen und Release Notes finden dort öffentlich statt.
Wir bauen das offen, auf europäischen Maschinen, für europäische Anwendungsfälle. Das ist der ganze Punkt.