Führen Sie KI dort aus, wo Ihre Daten liegen.
EuLLM Engine ist eine Open-Source-Laufzeitumgebung für große Sprachmodelle. Eine einzige Rust-Binärdatei, OpenAI- und Ollama-kompatibel, keine Telemetrie. Vom Raspberry Pi bis zur NVIDIA GH200 oder AMD Instinct MI250X.
Ihre Modelle. Ihre Infrastruktur. Ihre Daten.
$ curl -fsSL https://raw.githubusercontent.com/eullm/eullm/main/installer/install.sh | sh
$ eullm run hf.co/Qwen/Qwen3-8B-GGUF:Q4_K_M
Eine Laufzeitumgebung. Eine Plattform, um darauf aufzubauen.
Engine führt Modelle überall aus. Forge und Hub entwickeln und verteilen die, die Sie spezialisieren.
Engine
Eine Open-Source-Laufzeitumgebung für große Sprachmodelle. Eine einzige Binärdatei, OpenAI- und Ollama-kompatibel, keine Telemetrie.
Engine-Dokumentation lesen →Forge — spezialisieren
Feinabstimmung, Destillation und Evaluierung offener Modelle mit Ihren Daten. Kleine Spezialisten, die präzise aus Ihren Dokumenten und Quellen antworten, exportiert als GGUF, das Ihnen gehört und auf Engine läuft.
Platform entdeckenHub — verteilen
Veröffentlichen, versionieren und entdecken Sie Modelle, jedes mit einer Modellkarte und einer Compliance-Karte. Selbst hostbar, mit einer EU-gehosteten Region.
Platform entdeckenOpen Source, gebaut in Europa
EuLLM ist Open Source (AGPL-3.0) und wird von I3K Technologies in Mailand entwickelt. Wir trainieren und benchmarken auf den EuroHPC-Supercomputern Leonardo, LUMI und JUPITER. Gebaut in Europa, von Ihnen überall einsetzbar.
Datensouveränität →
Vom offenen Modell zum Spezialisten, bis zur Produktion
Spezialisieren
Forge feintunt und destilliert ein Open-Weight-Modell auf Ihren eigenen Daten.
Evaluieren
Held-out-Benchmarks messen die Genauigkeit, bevor etwas veröffentlicht wird.
Veröffentlichen
Hub versioniert es mit einer Modellkarte und einer Compliance-Karte.
Ausführen
Engine führt es überall aus — Laptop, Server oder Edge.
Warum EuLLM Engine
- ~10 ms
- pro Entscheidung
- 2B-Modell entscheidet jeden Snake-Zug auf einer RTX 5070 Ti
- 1,065 tok/s
- bei 16 gleichzeitigen Nutzern
- auf einer RTX 5070 Ti, 8.1× eine einzelne Anfrage
- 10.8 tok/s
- 35B MoE, nur CPU
- auf einem 20-W-ARM-Board (Radxa Orion O6)
- CUDA · ROCm · Vulkan · Metal · CPU
- Läuft überall
- eine Engine, jedes Backend
Privat per Voreinstellung
Prompts, Dokumente und Antworten verlassen niemals Ihren Rechner. Keine Telemetrie, keine externe API.
Direkter Ersatz
Ollama- und OpenAI-APIs auf Port 11434. Open WebUI, LangChain, n8n und jeder OpenAI-Client funktionieren unverändert.
Schnell, wo es zählt
Continuous Batching, quantisierter KV-Cache für lange Kontexte, große MoE-Modelle auf kleinen GPUs.
Entscheidungen, nicht nur Text
/v1/systemone liest die Wahrscheinlichkeit jeder Option direkt aus dem Modell: strukturierte Entscheidungen in Millisekunden, für Routing, Triage und Agenten.
Läuft überall
Laptop, Workstation, On-Prem-Server, Edge-Gerät, Private Cloud. Eine Binärdatei, kein Python, kein Docker erforderlich.
Audit-Trail integriert
Jede Anfrage wird lokal in einer Datei protokolliert, die Sie kontrollieren – bereit für Ihre Prüfer.
Eine Chat-Oberfläche ist integriert, unter localhost:11435.
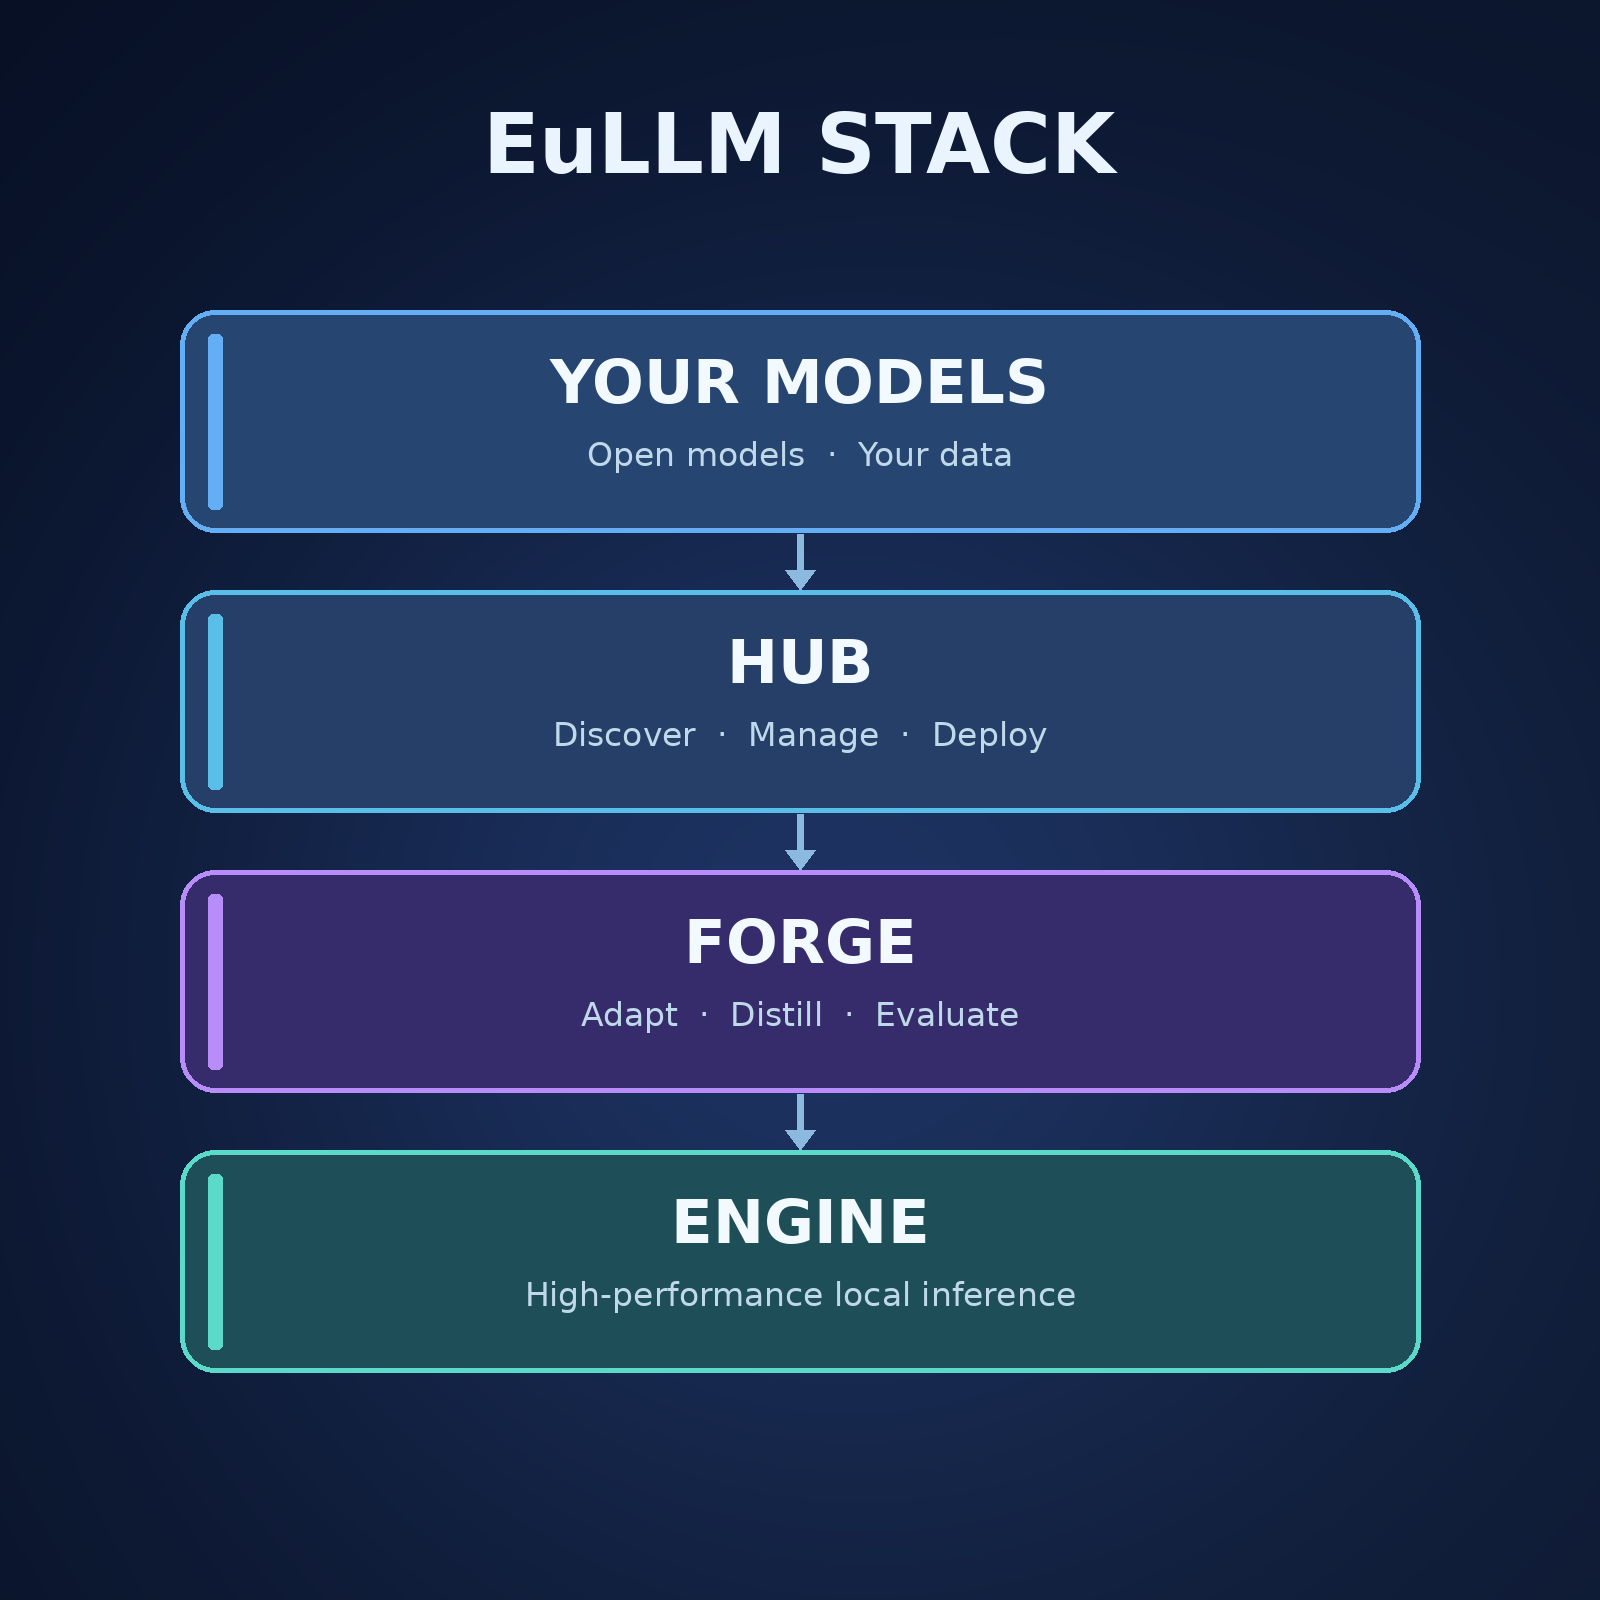
Ein Stack, drei Schichten
Spezialistenmodelle, die Ihnen gehören, aufgebaut auf einer offenen Plattform, bereitgestellt von einer Laufzeitumgebung, die überall läuft.
Ihre Modelle
Spezialisiert, evaluiert, und Ihnen zum Ausführen überlassen — GGUF-Dateien, die vollständig Ihnen gehören.
Hub — verteilen
PrototypVeröffentlichen, versionieren und entdecken Sie Modelle, jedes mit einer Modellkarte und einer Compliance-Karte. Selbst hostbar, mit einer EU-gehosteten Region.
Forge — spezialisieren
In EntwicklungFeinabstimmung, Destillation und Evaluierung offener Modelle mit Ihren Daten. Kleine Spezialisten, die präzise aus Ihren Dokumenten und Quellen antworten, exportiert als GGUF, das Ihnen gehört und auf Engine läuft.
Engine
Führt jedes GGUF-Modell aus, auf jeder Hardware, mit keiner Telemetrie.
Veröffentlicht: legal-it-4b und legal-it-8b für italienisches Recht, evaluiert anhand von 429 zurückgehaltenen Fragen.
Open Source. Von Ihnen betrieben. Von allen verbessert.
Offen, überall wo Sie bereits arbeiten
EuLLM lässt sich in die Tools und die Infrastruktur integrieren, die Sie bereits verwenden.

GitHub
Open Source, AGPL-3.0. Jede Zeile überprüfbar.
Hugging Face
Veröffentlichte Spezialistenmodelle, bereit zum Download.
I3K RAG Engine
Retrieval-System, entwickelt für die Spezialistenmodelle von EuLLM.
EuroHPC
Trainiert und getestet auf Leonardo, LUMI und JUPITER.
Gebaut für regulierte Arbeit
Recht, Gesundheitswesen, Finanzen und öffentliche Verwaltung können ihre Daten nicht der API eines Dritten anvertrauen. EuLLM läuft vollständig auf Infrastruktur, die Sie kontrollieren, protokolliert jede Anfrage lokal und liefert Modell- und Compliance-Karten zu jedem Platform-Modell.
- Lokaler Audit-Trail für jede Inferenz
- Unterstützung bei der Dokumentation für den EU AI Act und die DSGVO
- Spezialmodelle für Recht, Medizin und Finanzen (zuerst Recht)
- EU-gehostete Hub-Region für Organisationen, die dies benötigen
Keine Binärdatei und keine Compliance-Karte allein macht ein System konform: Compliance ist eine Eigenschaft des gesamten Systems und seiner Governance.
Neueste Artikel
29. September 2026 · 6 min read
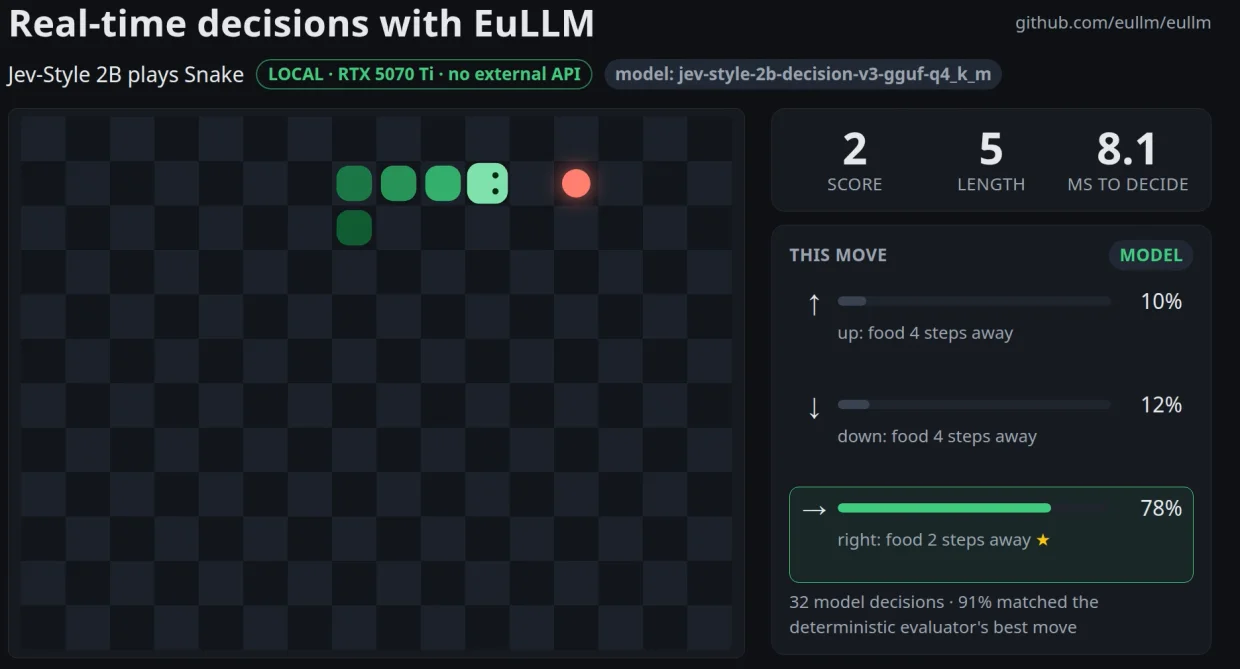
Von Tokens zu Entscheidungen: Ein 2B Jev-Style Decision Model lokal mit EuLLM betreiben
Ein 2B Jev-Style Decision Model, das lokal mit EuLLM läuft, trifft Echtzeit-Entscheidungen in rund 10 ms auf einer RTX 5070 Ti, ganz ohne externe API.
Weiterlesen →
12. September 2026 · 4 min read
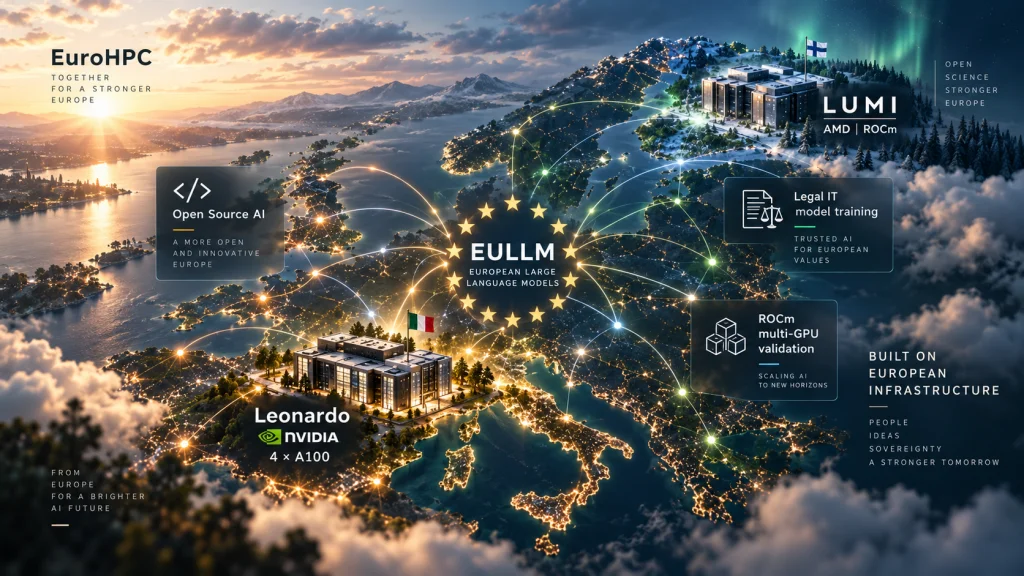
Wir haben Rechenzeit auf Leonardo und LUMI bekommen. Das bauen wir damit.
EULLM hat Rechenzeit auf zwei EuroHPC-Supercomputern erhalten: Leonardo in Bologna und LUMI in Finnland. Wir bauen unser erstes vertikales Modell auf A100s und validieren ROCm-Multi-GPU auf dem größten AMD-Cluster des Kontinents.
Weiterlesen →
Ihre Modelle. Ihre Infrastruktur. Ihre Daten.
Installieren Sie EuLLM Engine mit einem einzigen Befehl, oder sprechen Sie mit uns über ein Spezialmodell für Ihren Bereich.