Hace dos semanas iniciamos sesión en dos terminales que se veían muy diferentes a nuestras máquinas de desarrollo habituales. Uno nos recibió con un banner ASCII «LEONARDO» y una cola SLURM. El otro, un «LUMI» renderizado en letras de bloques de píxeles, se describía como «The Supercomputer of the North».
Ambos son sistemas del EuroHPC Joint Undertaking. Ambos están entre los computadores más potentes del continente. Y ambos forman ahora parte de cómo construimos EULLM.
Qué obtuvimos
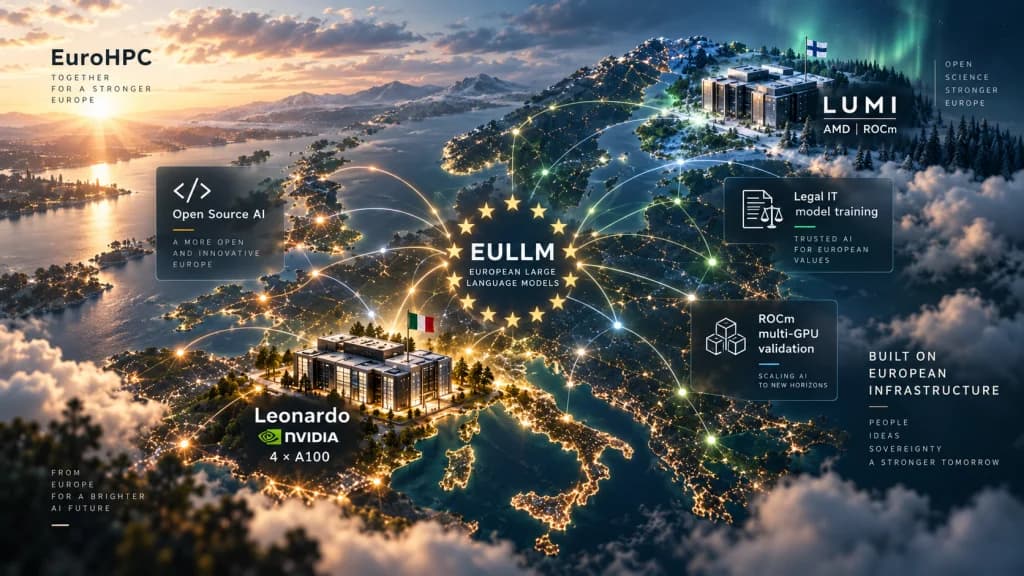
Leonardo está alojado en Cineca en Bolonia, Italia. El módulo booster al que tenemos acceso ejecuta 3.456 nodos de cómputo, cada uno con 32 núcleos Ice Lake a 2,60 GHz, 512 GB de RAM y cuatro GPU NVIDIA Ampere A100 con 64 GB de VRAM. La interconexión es Infiniband Dragonfly+ 200G HDR. Es, en pocas palabras, una máquina seria.
LUMI está alojado en CSC en Kajaani, Finlandia. Se llama a sí mismo «The Supercomputer of the North», y los números lo justifican. Lo crítico para nosotros: la partición GPU de LUMI está construida íntegramente sobre hardware AMD — lo que significa ROCm, no CUDA.
Qué estamos haciendo en Leonardo
El trabajo principal en Leonardo es nuestro primer modelo vertical: Legal IT.
El objetivo es un especialista 7B entrenado sobre jurisprudencia italiana seleccionada, el código civil y el corpus regulatorio de la UE — un modelo que comprende contratos, evaluaciones RGPD y preguntas de cumplimiento UE de una manera que un generalista de 70B no puede. No porque sea más grande, sino porque cada parámetro es relevante.
El pipeline: un modelo frontier open-weight de 70B como maestro, structural pruning para eliminar capacidad irrelevante al razonamiento jurídico, knowledge distillation en el estudiante de 7B, cuantización para eficiencia en inferencia, e identity fine-tuning para persona e instrucciones. El pipeline Forge, en otras palabras, ejecutado en hierro real.
Antes de llegar al entrenamiento, queríamos verificar que EULLM Engine pudiera realmente manejar el hardware. Así que ejecutamos un modelo de 27B en las cuatro A100 de un nodo único. Funcionó. El camino de inferencia multi-GPU — basado en CUDA, usando el batching y la gestión de memoria propios de EULLM — manejó un GGUF de 27B sin problemas, con las ganancias de rendimiento esperadas al distribuir los pesos del modelo en cuatro tarjetas de 64 GB.
Ese es un dato significativo. Nos dice que cuando Legal IT 7B esté disponible, una organización europea con un nodo 4×A100 único (on-premise o en la nube) podrá ejecutarlo cómodamente — con margen para servir usuarios concurrentes.
Qué estamos haciendo en LUMI
LUMI es un desafío diferente. La partición GPU de LUMI ejecuta aceleradores AMD Instinct, lo que significa que el stack relevante es ROCm, no CUDA.
Esto importa más de lo que podría parecer. «Corre en GPU» no es un monolito. El código que funciona perfectamente en tarjetas NVIDIA puede no compilar, puede fallar o puede ejecutarse con mal rendimiento en hardware AMD. EULLM Engine ya incluye soporte ROCm — lo marcamos como experimental en las notas de versión — pero experimental no es validado.
LUMI es donde lo validamos correctamente. El objetivo: ejecutar el stack de inferencia de EULLM en múltiples GPU AMD y confirmar que el rendimiento, la corrección y la estabilidad se mantienen bajo carga real. Usamos los mismos pesos de modelos, la misma superficie API, en silicio radicalmente diferente.
¿Por qué importa esto para la soberanía IA europea? Porque el lock-in de hardware es una forma de dependencia. Si EULLM solo funciona de forma fiable en NVIDIA, las organizaciones europeas que ejecutan infraestructura AMD — y hay despliegues AMD significativos en redes HPC y de investigación europeas — quedan excluidas. LUMI nos da un entorno AMD multi-GPU real en lugar de un simulador o una máquina de prueba de una sola tarjeta.
Por qué EuroHPC
Podríamos haber alquilado tiempo GPU a un hyperscaler estadounidense. No lo hicimos.
Los sistemas EuroHPC son infraestructura pública europea. Los datos sobre los que computamos permanecen dentro de la jurisdicción europea. El proceso de asignación es competitivo y basado en méritos — se presenta una descripción del proyecto, se explica qué se está construyendo y por qué necesita el cómputo, y un comité decide. Creemos que hay algo correcto en construir un stack IA soberano europeo sobre cómputo soberano europeo.
También hay un argumento práctico: el hardware en Leonardo y LUMI es genuinamente excelente. Cuatro tarjetas A100 de 64 GB por nodo no es algo que se pueda replicar fácilmente en instancias spot. La escala de GPU AMD de LUMI simplemente no está disponible para alquilar en ningún otro lugar de Europa.
Qué viene después
Legal IT es un pipeline en progreso. La curación del dataset está casi completa. Las sesiones de pruning y distillation ocurrirán en las próximas semanas en Leonardo. Cuando el modelo 7B pase nuestros umbrales internos de calidad — y la ficha de conformidad AI Act esté redactada — entrará en el Hub.
Para LUMI: las sesiones de validación multi-GPU ROCm están en curso. Publicaremos una nota técnica con benchmarks cuando los resultados sean suficientemente sólidos como para respaldarlos.
Si está construyendo sobre infraestructura europea y quiere saber cuándo Legal IT estará disponible, el mejor lugar para seguir es nuestro GitHub. Issues, discusiones y notas de versión ocurren allí públicamente.
Estamos construyendo esto en abierto, en máquinas europeas, para casos de uso europeos. Ese es el punto.