Ejecute IA donde viven sus datos.
EuLLM Engine es un runtime de código abierto para grandes modelos de lenguaje. Un único binario en Rust, compatible con OpenAI y Ollama, cero telemetría. Desde una Raspberry Pi hasta una NVIDIA GH200 o una AMD Instinct MI250X.
Sus modelos. Su infraestructura. Sus datos.
$ curl -fsSL https://raw.githubusercontent.com/eullm/eullm/main/installer/install.sh | sh
$ eullm run hf.co/Qwen/Qwen3-8B-GGUF:Q4_K_M
Un runtime. Una plataforma sobre la que construir.
Engine ejecuta modelos en cualquier lugar. Forge y Hub crean y distribuyen los que usted especializa.
Engine
Un runtime de código abierto para grandes modelos de lenguaje. Un único binario, compatible con OpenAI y Ollama, cero telemetría.
Leer la documentación de Engine →Forge — especializar
Ajuste, destile y evalúe modelos abiertos con sus datos. Pequeños especialistas que responden con precisión a partir de sus documentos y fuentes, exportados como un GGUF que usted posee y ejecuta en Engine.
Explorar la PlatformHub — distribuir
Publique, versione y descubra modelos, cada uno con una ficha de modelo y una ficha de conformidad. Autoalojable, con una región alojada en la UE.
Explorar la PlatformCódigo abierto, desarrollado en Europa
EuLLM es de código abierto (AGPL-3.0) y está desarrollado en Milán por I3K Technologies. Entrenamos y evaluamos en los superordenadores EuroHPC Leonardo, LUMI y JUPITER. Desarrollado en Europa, suyo para ejecutar en cualquier lugar.
Soberanía de datos →
De modelo abierto a especialista, hasta producción
Especializar
Forge ajusta y destila un modelo open-weight con sus propios datos.
Evaluar
Benchmarks held-out miden la precisión antes de publicar nada.
Publicar
Hub lo versiona con una ficha de modelo y una ficha de conformidad.
Ejecutar
Engine lo ejecuta en cualquier lugar — portátil, servidor o edge.
Por qué EuLLM Engine
- ~10 ms
- por decisión
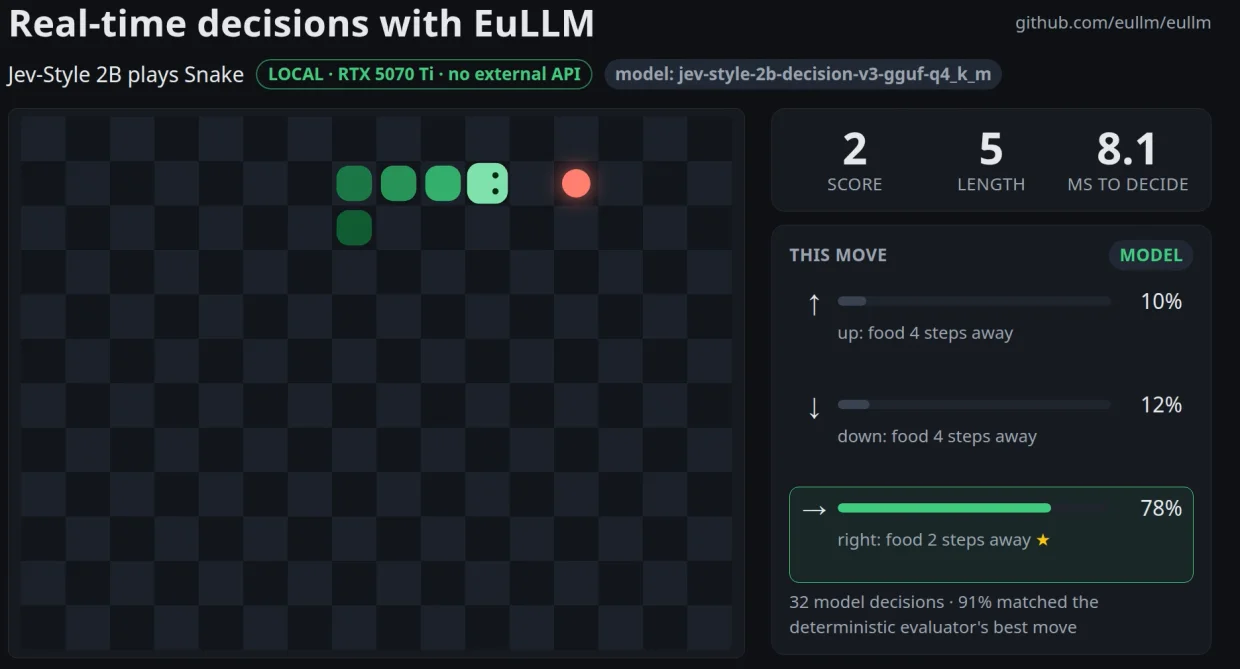
- Un modelo de 2B decidiendo cada movimiento de Snake en una RTX 5070 Ti
- 1,065 tok/s
- con 16 usuarios simultáneos
- en una RTX 5070 Ti, 8.1× una sola solicitud
- 10.8 tok/s
- MoE de 35B, solo CPU
- en una placa ARM de 20 W (Radxa Orion O6)
- CUDA · ROCm · Vulkan · Metal · CPU
- Funciona en cualquier lugar
- un único motor, todos los backends
Privado por defecto
Los prompts, documentos y respuestas nunca salen de su máquina. Sin telemetría, sin API externa.
Sustitución directa
APIs de Ollama y OpenAI en el puerto 11434. Open WebUI, LangChain, n8n y cualquier cliente OpenAI funcionan sin cambios.
Rápido donde importa
Continuous batching, caché KV cuantizada para contextos largos, modelos MoE grandes en GPUs pequeñas.
Decisiones, no solo texto
/v1/systemone lee la probabilidad de cada opción directamente del modelo: decisiones estructuradas en milisegundos, para enrutamiento, triaje y agentes.
Funciona en cualquier lugar
Portátil, estación de trabajo, servidor on-premise, dispositivo edge, nube privada. Un solo binario, sin Python ni Docker.
Registro de auditoría integrado
Cada solicitud se registra localmente en un archivo que usted controla, listo para sus auditores.
Incluye una interfaz de chat integrada, en localhost:11435.
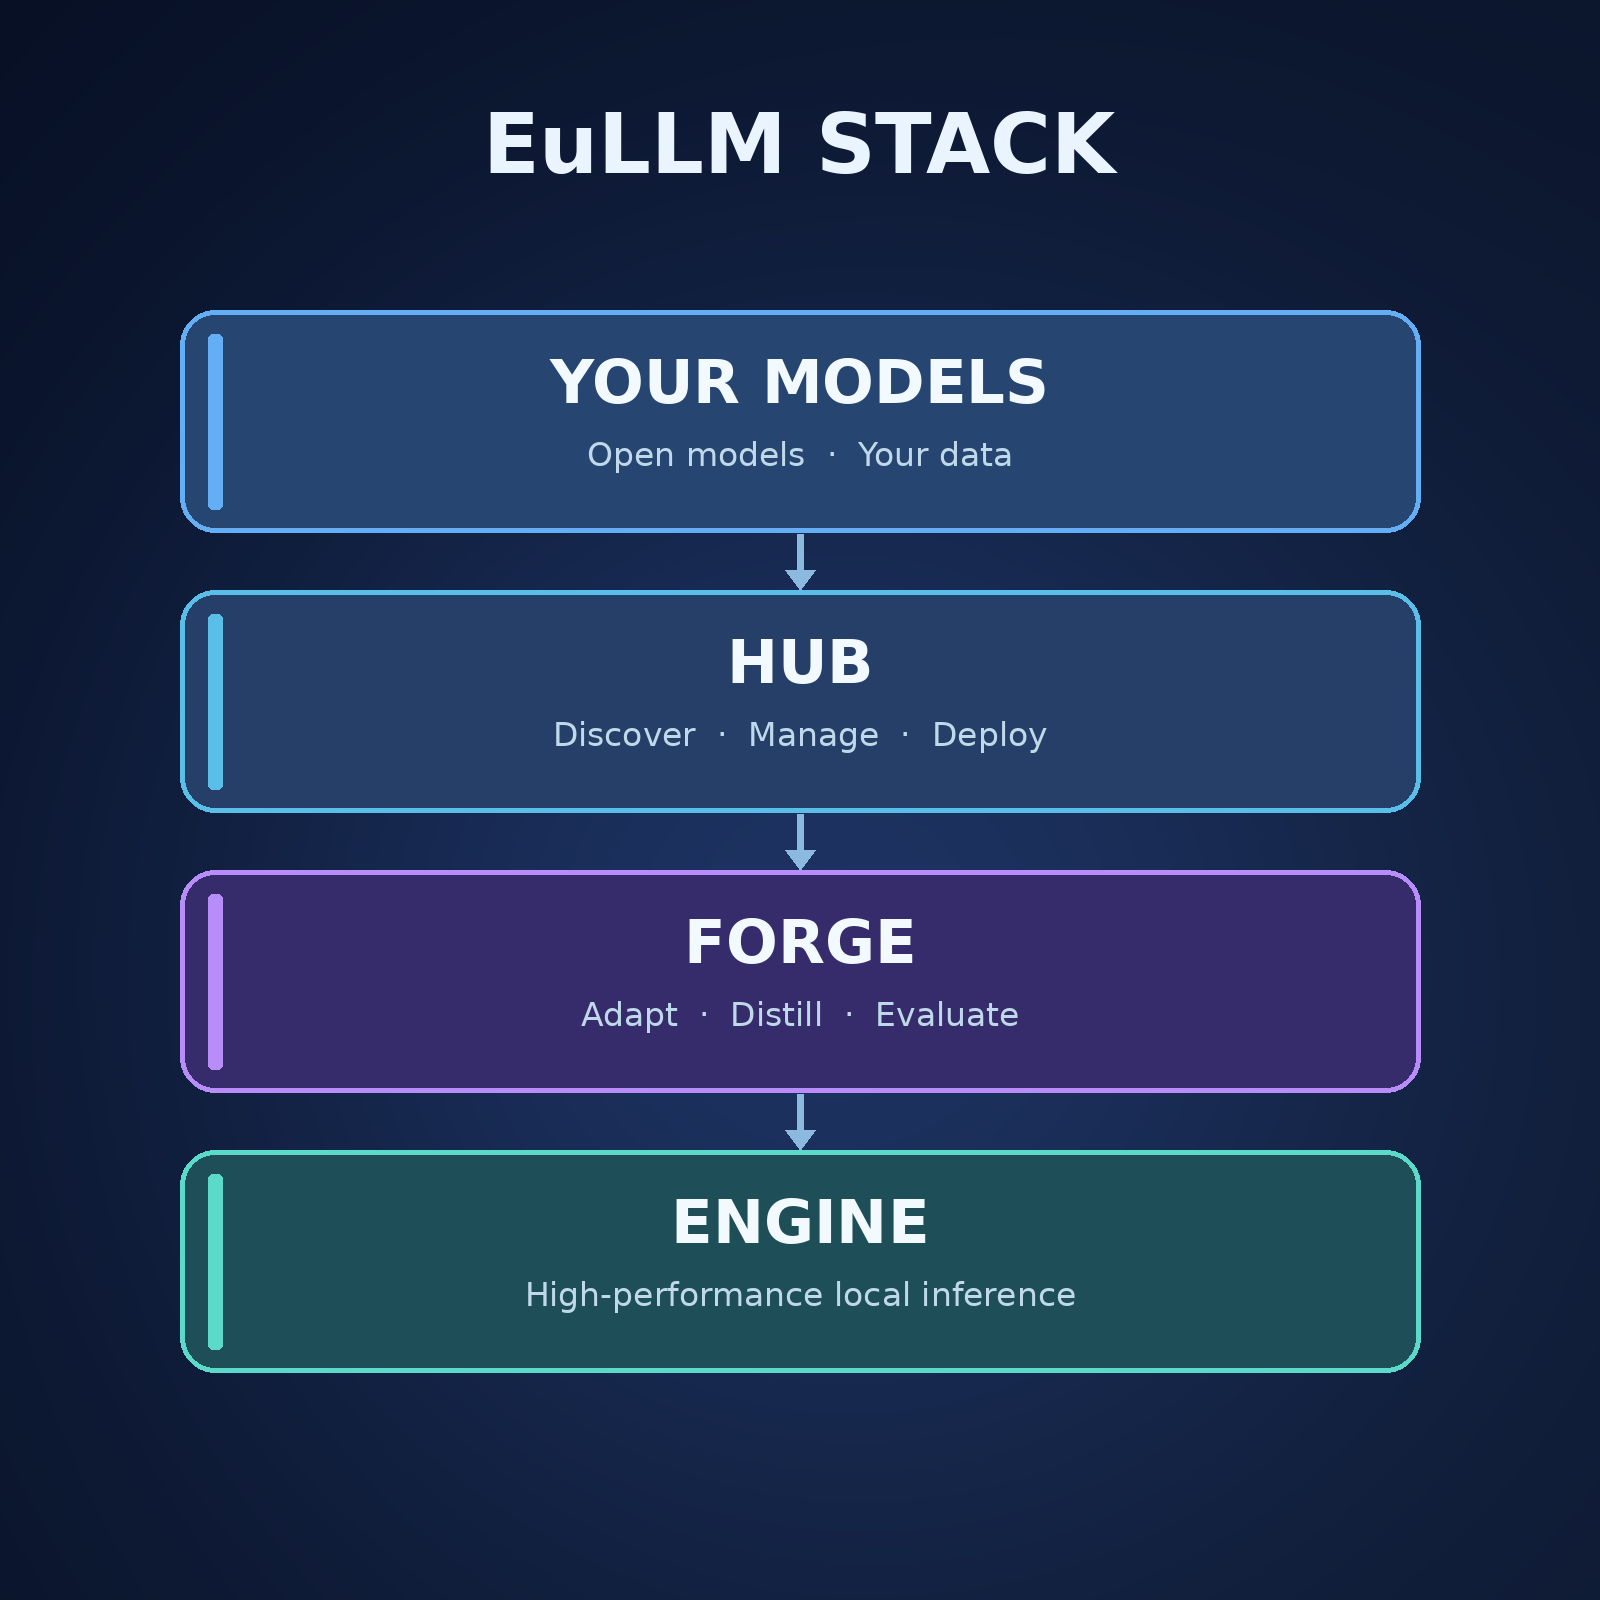
Una pila, tres capas
Modelos especialistas que usted posee, construidos sobre una plataforma abierta, servidos por un runtime que se ejecuta en cualquier lugar.
Sus modelos
Especializados, evaluados, y suyos para ejecutar — archivos GGUF que posee por completo.
Hub — distribuir
PrototipoPublique, versione y descubra modelos, cada uno con una ficha de modelo y una ficha de conformidad. Autoalojable, con una región alojada en la UE.
Forge — especializar
En desarrolloAjuste, destile y evalúe modelos abiertos con sus datos. Pequeños especialistas que responden con precisión a partir de sus documentos y fuentes, exportados como un GGUF que usted posee y ejecuta en Engine.
Engine
Ejecuta cualquier modelo GGUF, en cualquier hardware, con cero telemetría.
Publicado: legal-it-4b y legal-it-8b para derecho italiano, evaluados en 429 preguntas reservadas.
Código abierto. Ejecutado por usted. Mejorado por todos.
Abierto, en todas partes donde ya trabaja
EuLLM se integra con las herramientas e infraestructura que ya utiliza.

GitHub
Código abierto, AGPL-3.0. Cada línea verificable.
Hugging Face
Modelos especialistas publicados, listos para descargar.
I3K RAG Engine
Sistema de recuperación creado para los modelos especialistas de EuLLM.
EuroHPC
Entrenado y evaluado en Leonardo, LUMI y JUPITER.
Diseñado para trabajo regulado
Los sectores jurídico, sanitario, financiero y la administración pública no pueden entregar sus datos a la API de otro. EuLLM se ejecuta íntegramente en infraestructura que usted controla, registra cada solicitud localmente y entrega fichas de modelo y de conformidad con cada modelo de Platform.
- Registro de auditoría local para cada inferencia
- Soporte documental para la AI Act de la UE y el RGPD
- Modelos especialistas para trabajo jurídico, médico y financiero (jurídico primero)
- Región de Hub alojada en la UE para las organizaciones que lo requieran
Ningún binario ni ficha de conformidad por sí sola hace que un sistema sea conforme: el cumplimiento es una propiedad de todo el sistema y su gobernanza.
Últimos artículos
29 de septiembre de 2026 · 7 min read
De tokens a decisiones: ejecutar en local un Decision Model Jev-style de 2B con EuLLM
Un Decision Model Jev-style de 2B ejecutándose en local con EuLLM toma decisiones en tiempo real en unos 10 ms en una RTX 5070 Ti, sin ninguna API externa.
Leer más →
12 de septiembre de 2026 · 5 min read
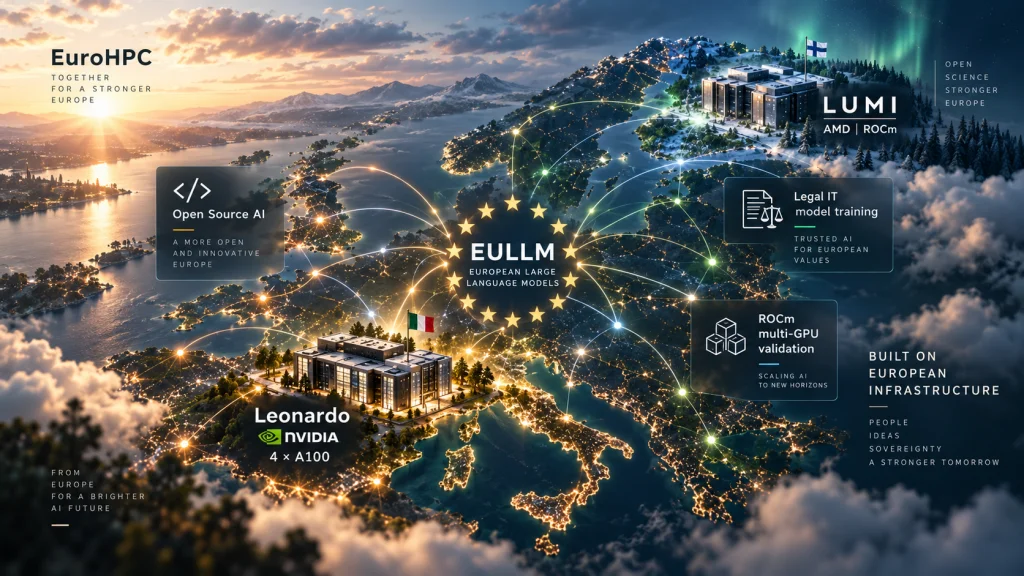
Obtuvimos tiempo en Leonardo y LUMI. Esto es lo que estamos construyendo.
EULLM ha recibido tiempo de cómputo en dos supercomputadores EuroHPC: Leonardo en Bolonia y LUMI en Finlandia. Estamos construyendo nuestro primer modelo vertical en A100 y validando ROCm multi-GPU en el mayor clúster AMD del continente.
Leer más →
Sus modelos. Su infraestructura. Sus datos.
Instale EuLLM Engine con un solo comando, o hable con nosotros sobre un modelo especialista para su sector.