Il y a deux semaines, nous nous sommes connectés à deux terminaux qui ressemblaient très peu à nos machines de développement habituelles. L'un nous a accueillis avec une bannière ASCII « LEONARDO » et une file d'attente SLURM. L'autre, un « LUMI » rendu en blocs pixel, se décrivait comme « The Supercomputer of the North ».
Les deux sont des systèmes de l'EuroHPC Joint Undertaking. Les deux comptent parmi les ordinateurs les plus puissants du continent. Et les deux font désormais partie de la façon dont nous construisons EULLM.
Ce que nous avons obtenu
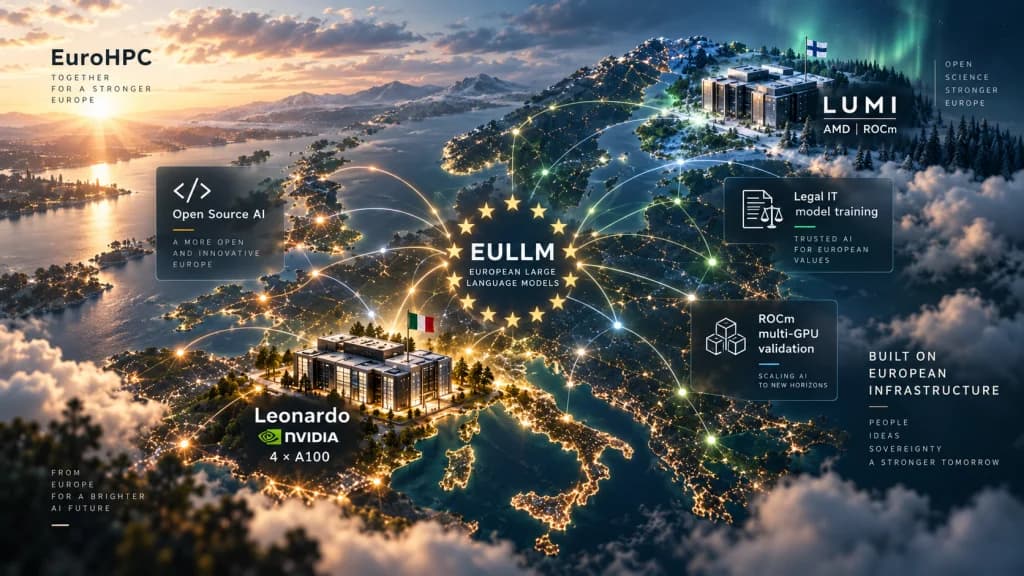
Leonardo est hébergé au Cineca à Bologne, en Italie. Le module booster auquel nous avons accès comprend 3 456 nœuds de calcul, chacun avec 32 cœurs Ice Lake à 2,60 GHz, 512 Go de RAM et quatre GPU NVIDIA Ampere A100 avec 64 Go de VRAM. L'interconnexion est Infiniband Dragonfly+ 200G HDR. C'est, en un mot, une machine sérieuse.
LUMI est hébergé au CSC à Kajaani, en Finlande. Il se présente comme « The Supercomputer of the North », et les chiffres le justifient. Ce qui compte pour nous : la partition GPU de LUMI est entièrement construite sur du matériel AMD — ce qui signifie ROCm, et non CUDA.
Ce que nous faisons sur Leonardo
Le travail principal sur Leonardo est notre premier modèle vertical : Legal IT.
L'objectif est un spécialiste 7B entraîné sur de la jurisprudence italienne sélectionnée, le code civil et le corpus réglementaire de l'UE — un modèle qui comprend les contrats, les évaluations RGPD et les questions de conformité UE d'une manière qu'un généraliste 70B ne peut pas. Non pas parce qu'il est plus grand, mais parce que chaque paramètre est pertinent.
Le pipeline : un modèle frontier open-weight 70B comme enseignant, un structural pruning pour supprimer la capacité non pertinente au raisonnement juridique, la knowledge distillation dans l'étudiant 7B, la quantisation pour l'efficacité à l'inférence, et l'identity fine-tuning pour la persona et les instructions. Le pipeline Forge, en somme, exécuté sur du vrai matériel.
Avant de commencer l'entraînement, nous voulions vérifier qu'EULLM Engine pouvait effectivement piloter le matériel. Nous avons donc fait tourner un modèle 27B sur les quatre A100 d'un nœud unique. Ça a fonctionné. Le chemin d'inférence multi-GPU — basé sur CUDA, avec le batching et la gestion mémoire propres à EULLM — a géré un GGUF 27B sans problème, avec les gains de débit attendus de la distribution des poids du modèle sur quatre cartes 64 Go.
C'est un point de données significatif. Il nous indique que lorsque Legal IT 7B sera disponible, une organisation européenne disposant d'un nœud 4×A100 unique (on-premise ou cloud) pourra le faire tourner confortablement — avec de la marge pour servir des utilisateurs simultanés.
Ce que nous faisons sur LUMI
LUMI est un défi différent. La partition GPU de LUMI utilise des accélérateurs AMD Instinct, ce qui signifie que le stack pertinent est ROCm, pas CUDA.
Cela compte plus qu'il n'y paraît. « Tourne sur GPU » n'est pas un monolithe. Du code qui fonctionne parfaitement sur des cartes NVIDIA peut ne pas compiler, planter, ou tourner avec de mauvaises performances sur du matériel AMD. EULLM Engine fournit déjà le support ROCm — nous l'avons marqué comme expérimental dans les notes de version — mais expérimental n'est pas validé.
LUMI est l'endroit où nous le validons sérieusement. L'objectif : faire tourner le stack d'inférence d'EULLM sur plusieurs GPU AMD et confirmer que le débit, la correction et la stabilité tiennent sous charge réelle. Nous utilisons les mêmes poids de modèles, la même surface API, sur du silicium radicalement différent.
Pourquoi est-ce important pour la souveraineté IA européenne ? Parce que le lock-in matériel est une forme de dépendance. Si EULLM ne fonctionne de manière fiable que sur NVIDIA, les organisations européennes fonctionnant sur infrastructure AMD — et il existe des déploiements AMD significatifs dans les réseaux HPC et de recherche européens — sont laissées de côté. LUMI nous donne un vrai environnement AMD multi-GPU plutôt qu'un simulateur ou une machine de test à carte unique.
Pourquoi EuroHPC
Nous aurions pu louer du temps GPU auprès d'un hyperscaler américain. Nous ne l'avons pas fait.
Les systèmes EuroHPC sont des infrastructures publiques européennes. Les données sur lesquelles nous calculons restent dans la juridiction européenne. Le processus d'allocation est compétitif et basé sur le mérite — on soumet une description de projet, on explique ce qu'on construit et pourquoi cela nécessite de la puissance de calcul, et un comité décide. Nous pensons qu'il y a quelque chose de juste à construire un stack IA souverain européen sur du calcul souverain européen.
Il y a aussi un argument pratique : le matériel de Leonardo et LUMI est genuinement excellent. Quatre cartes A100 64 Go par nœud, ça ne se réplique pas facilement sur des instances spot. L'échelle de GPU AMD de LUMI n'est tout simplement pas disponible à la location ailleurs en Europe.
Ce qui vient ensuite
Legal IT est un pipeline en cours. La curation du dataset est presque terminée. Les sessions de pruning et distillation se dérouleront dans les prochaines semaines sur Leonardo. Lorsque le modèle 7B passera nos seuils de qualité internes — et que la fiche de conformité AI Act sera rédigée — il entrera dans le Hub.
Pour LUMI : les sessions de validation multi-GPU ROCm sont en cours. Nous publierons une note technique avec des benchmarks lorsque les résultats seront suffisamment solides pour être défendus.
Si vous construisez sur infrastructure européenne et souhaitez savoir quand Legal IT sera disponible, le meilleur endroit à suivre est notre GitHub. Les issues, discussions et notes de version s'y déroulent toutes publiquement.
Nous construisons ceci ouvertement, sur des machines européennes, pour des cas d'usage européens. C'est tout le point.