Exécutez l'IA là où vivent vos données.
EuLLM Engine est un runtime open source pour les grands modèles de langage. Un seul binaire Rust, compatible OpenAI et Ollama, zéro télémétrie. D'un Raspberry Pi à une NVIDIA GH200 ou une AMD Instinct MI250X.
Vos modèles. Votre infrastructure. Vos données.
$ curl -fsSL https://raw.githubusercontent.com/eullm/eullm/main/installer/install.sh | sh
$ eullm run hf.co/Qwen/Qwen3-8B-GGUF:Q4_K_M
Un runtime. Une plateforme pour construire dessus.
Engine exécute les modèles partout. Forge et Hub construisent et distribuent ceux que vous spécialisez.
Engine
Un runtime open source pour les grands modèles de langage. Un seul binaire, compatible OpenAI et Ollama, zéro télémétrie.
Lire la documentation Engine →Forge — spécialiser
Fine-tunez, distillez et évaluez des modèles ouverts sur vos données. De petits spécialistes qui répondent avec précision à partir de vos documents et sources, exportés en GGUF que vous possédez et exécutez sur Engine.
Explorer la PlatformHub — distribuer
Publiez, versionnez et découvrez des modèles, chacun avec une fiche modèle et une fiche de conformité. Auto-hébergeable, avec une région hébergée dans l'UE.
Explorer la PlatformOpen source, conçu en Europe
EuLLM est open source (AGPL-3.0) et conçu à Milan par I3K Technologies. Nous entraînons et évaluons sur les supercalculateurs EuroHPC Leonardo, LUMI et JUPITER. Construit en Europe, à vous de l'exécuter n'importe où.
Souveraineté des données →
Du modèle ouvert au spécialiste, jusqu'à la production
Spécialiser
Forge affine et distille un modèle open-weight sur vos propres données.
Évaluer
Des benchmarks held-out mesurent la précision avant toute publication.
Publier
Hub le versionne avec une fiche modèle et une fiche de conformité.
Exécuter
Engine l'exécute partout — ordinateur portable, serveur ou edge.
Pourquoi EuLLM Engine
- ~10 ms
- par décision
- Un modèle 2B qui décide chaque mouvement de Snake sur une RTX 5070 Ti
- 1,065 tok/s
- avec 16 utilisateurs simultanés
- sur une seule RTX 5070 Ti, 8.1× une seule requête
- 10.8 tok/s
- MoE 35B, CPU uniquement
- sur une carte ARM 20 W (Radxa Orion O6)
- CUDA · ROCm · Vulkan · Metal · CPU
- Fonctionne partout
- un seul moteur, tous les backends
Privé par défaut
Les prompts, documents et réponses ne quittent jamais votre machine. Aucune télémétrie, aucune API externe.
Remplacement direct
APIs Ollama et OpenAI sur le port 11434. Open WebUI, LangChain, n8n et tout client OpenAI fonctionnent sans modification.
Rapide là où ça compte
Continuous batching, cache KV quantifié pour les longs contextes, grands modèles MoE sur petits GPU.
Des décisions, pas seulement du texte
/v1/systemone lit directement dans le modèle la probabilité de chaque option : des décisions structurées en quelques millisecondes, pour le routage, le triage et les agents.
Fonctionne partout
Ordinateur portable, poste de travail, serveur on-prem, appareil edge, cloud privé. Un seul binaire, ni Python ni Docker requis.
Piste d'audit intégrée
Chaque requête est enregistrée localement dans un fichier que vous contrôlez, prêt pour vos auditeurs.
Une interface de chat est intégrée, sur localhost:11435.
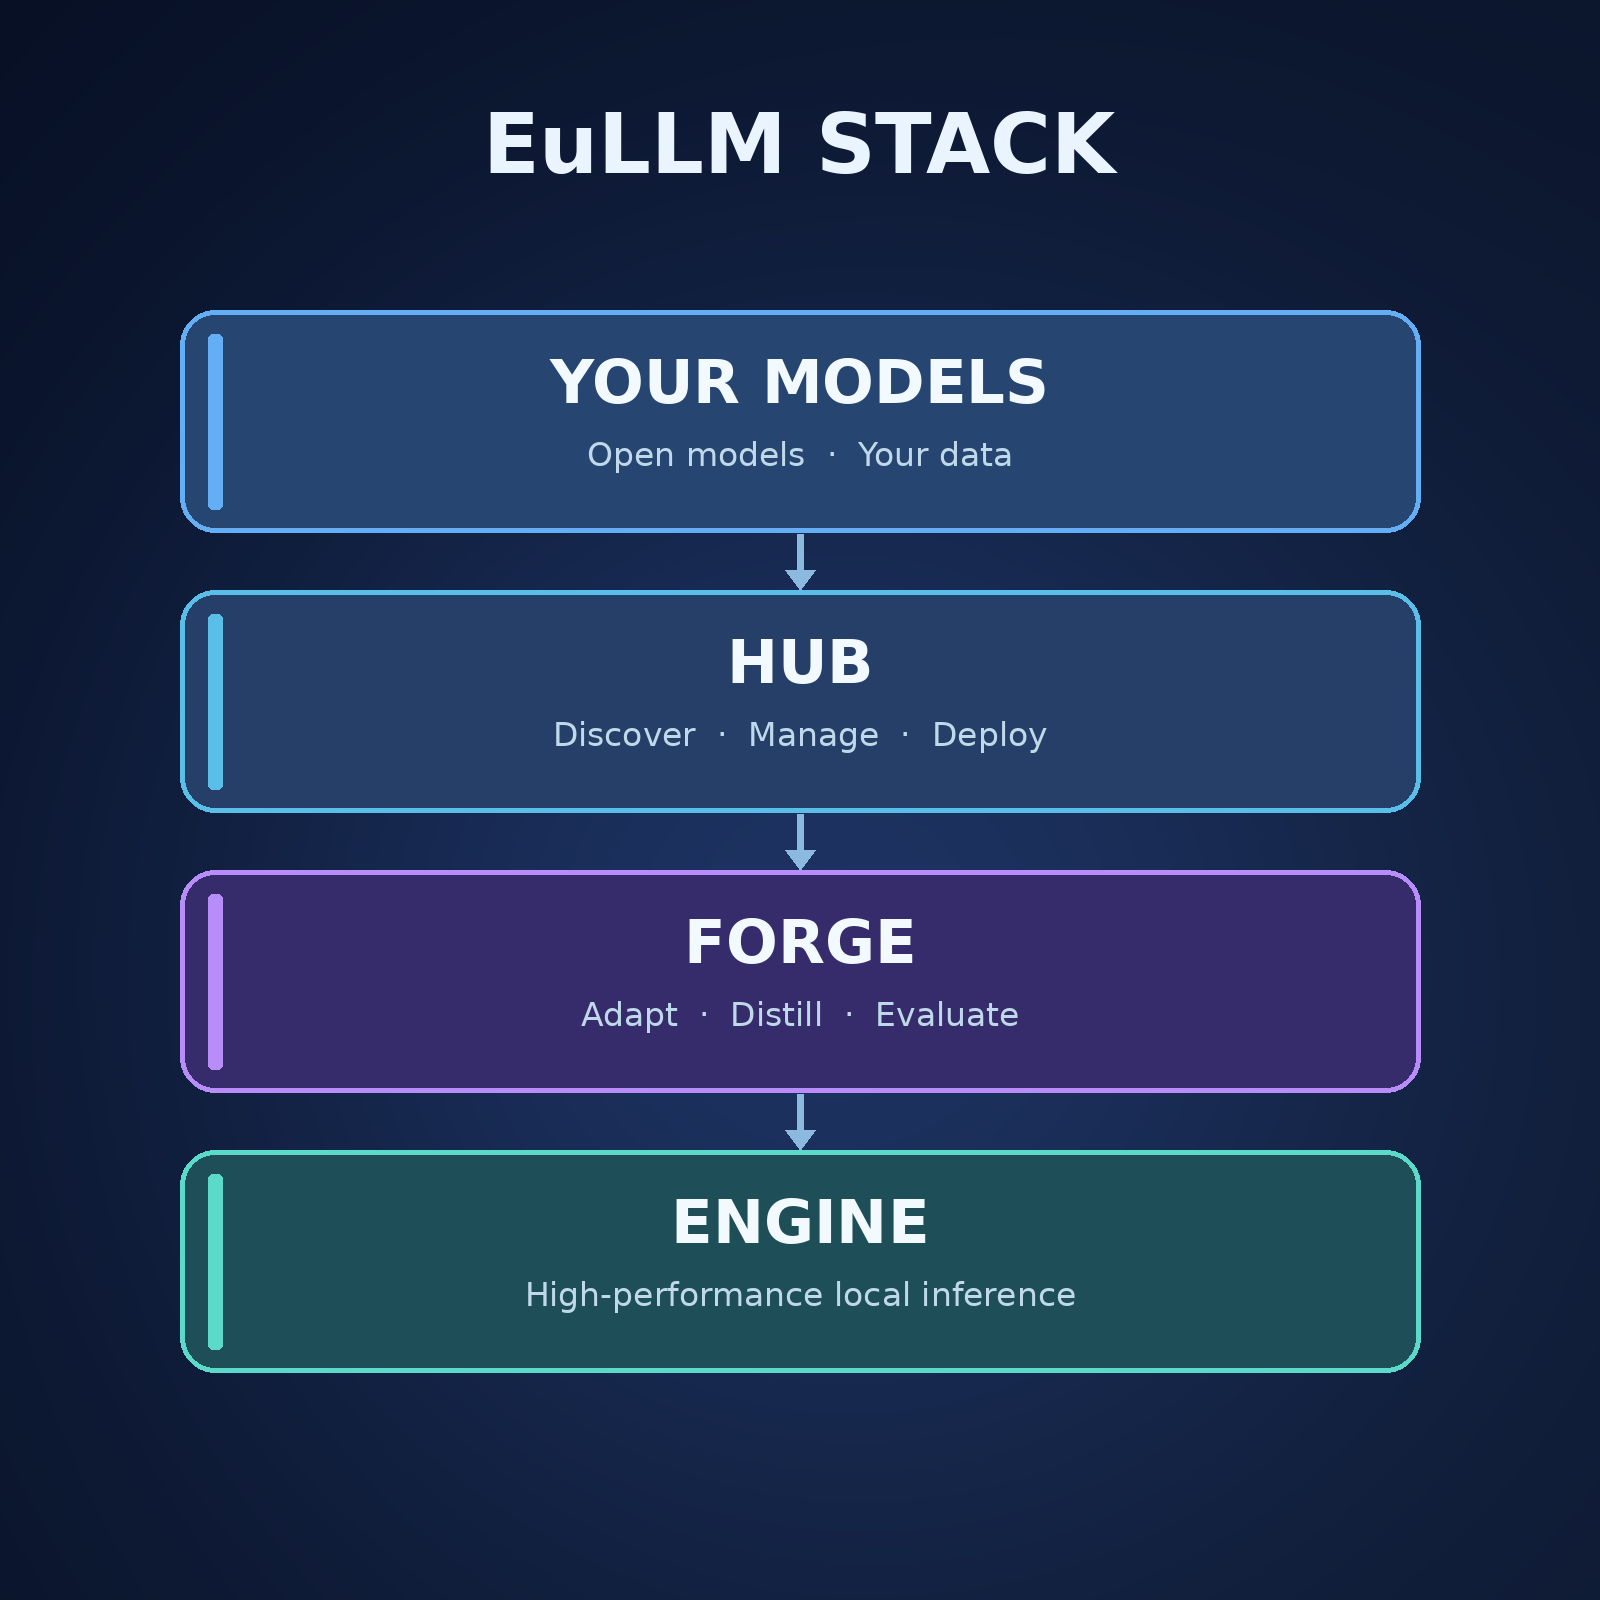
Une pile, trois couches
Des modèles spécialistes que vous possédez, construits sur une plateforme ouverte, servis par un runtime qui s'exécute partout.
Vos modèles
Spécialisés, évalués, et à vous d'exécuter — des fichiers GGUF que vous possédez entièrement.
Hub — distribuer
PrototypePubliez, versionnez et découvrez des modèles, chacun avec une fiche modèle et une fiche de conformité. Auto-hébergeable, avec une région hébergée dans l'UE.
Forge — spécialiser
En développementFine-tunez, distillez et évaluez des modèles ouverts sur vos données. De petits spécialistes qui répondent avec précision à partir de vos documents et sources, exportés en GGUF que vous possédez et exécutez sur Engine.
Engine
Exécute n'importe quel modèle GGUF, sur n'importe quel matériel, avec zéro télémétrie.
Publié : legal-it-4b et legal-it-8b pour le droit italien, évalués sur 429 questions retenues.
Open source. Exécuté par vous. Amélioré par tous.
Ouvert, partout où vous travaillez déjà
EuLLM s'intègre aux outils et à l'infrastructure que vous utilisez déjà.

GitHub
Open source, AGPL-3.0. Chaque ligne vérifiable.
Hugging Face
Modèles spécialistes publiés, prêts à télécharger.
I3K RAG Engine
Système de récupération conçu pour les modèles spécialistes d'EuLLM.
EuroHPC
Entraîné et testé sur Leonardo, LUMI et JUPITER.
Conçu pour les activités réglementées
Le droit, la santé, la finance et l'administration publique ne peuvent pas confier leurs données à l'API de quelqu'un d'autre. EuLLM fonctionne entièrement sur une infrastructure que vous contrôlez, enregistre chaque requête localement, et livre des fiches modèle et de conformité avec chaque modèle Platform.
- Piste d'audit locale pour chaque inférence
- Support documentaire pour l'AI Act européen et le RGPD
- Modèles spécialistes pour le droit, la médecine et la finance (le juridique en premier)
- Région Hub hébergée dans l'UE pour les organisations qui en ont besoin
Aucun binaire ni fiche de conformité ne rend à lui seul un système conforme : la conformité est une propriété de l'ensemble du système et de sa gouvernance.
Derniers articles
29 septembre 2026 · 7 min read
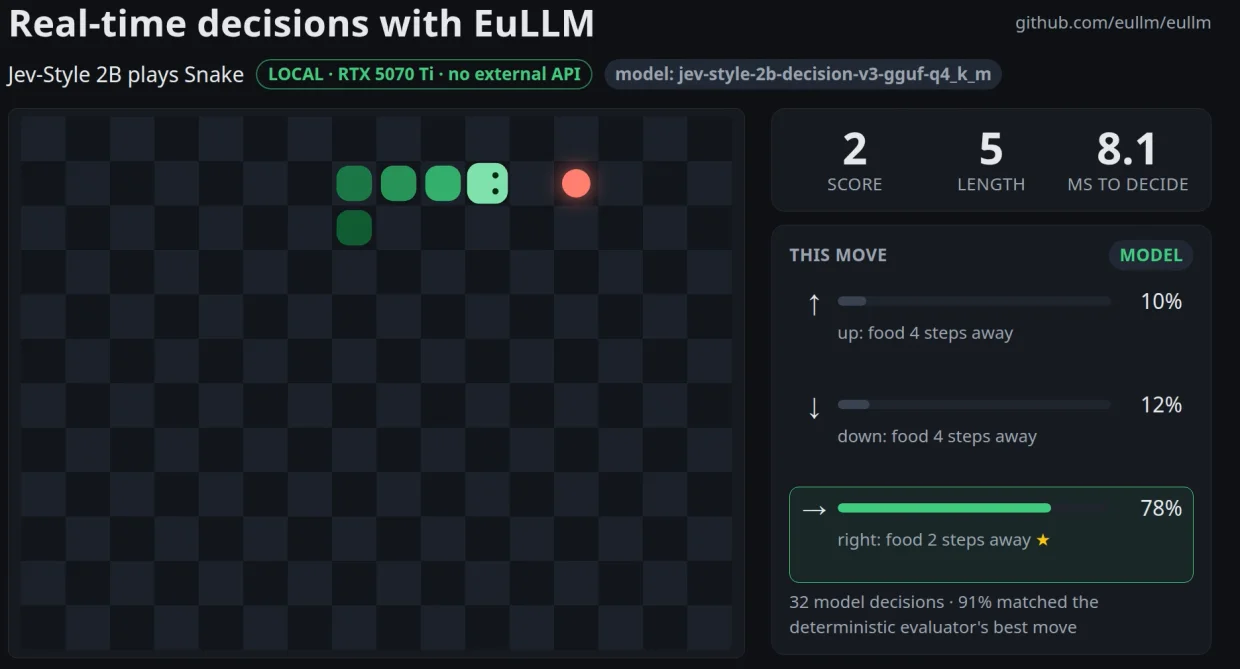
Des tokens aux décisions : faire tourner en local un Decision Model Jev-style de 2B avec EuLLM
Un Decision Model Jev-style de 2B tournant en local avec EuLLM prend des décisions en temps réel en environ 10 ms sur une RTX 5070 Ti, sans aucune API externe.
Lire la suite →
12 septembre 2026 · 5 min read
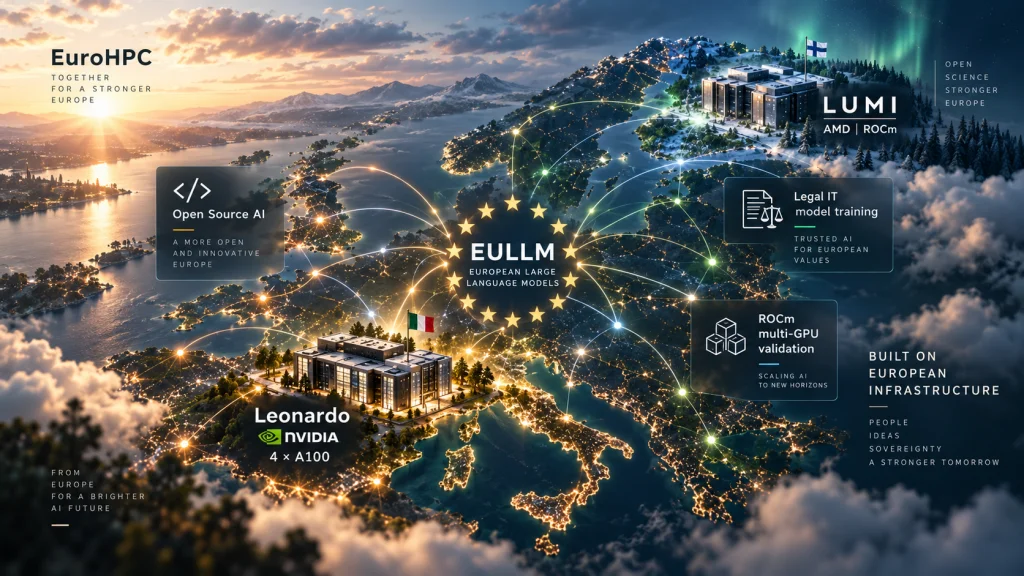
Nous avons obtenu du temps sur Leonardo et LUMI. Voici ce que nous construisons.
EULLM a reçu du temps de calcul sur deux supercalculateurs EuroHPC : Leonardo à Bologne et LUMI en Finlande. Nous construisons notre premier modèle vertical sur A100 et validons le multi-GPU ROCm sur le plus grand cluster AMD du continent.
Lire la suite →
Vos modèles. Votre infrastructure. Vos données.
Installez EuLLM Engine en une seule commande, ou parlez-nous d'un modèle spécialiste pour votre domaine.