Due settimane fa ci siamo collegati a due terminali che si presentavano in modo molto diverso dalle nostre macchine di sviluppo abituali. Uno ci ha accolti con un banner ASCII "LEONARDO" e una coda SLURM. L'altro, un "LUMI" disegnato a blocchi pixel, si descriveva come "The Supercomputer of the North."
Entrambi sono sistemi dell'EuroHPC Joint Undertaking. Entrambi sono tra i computer più potenti del continente. Ed entrambi fanno ora parte di come costruiamo EULLM.
Cosa abbiamo ottenuto
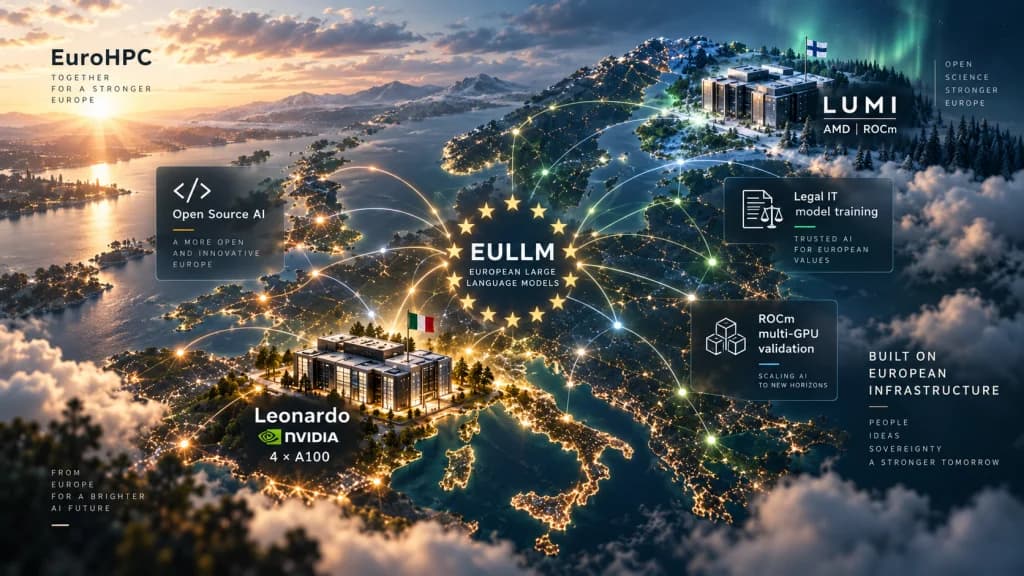
Leonardo è ospitato al Cineca di Bologna. Il modulo booster a cui abbiamo accesso conta 3.456 nodi di calcolo, ciascuno con 32 core Ice Lake a 2,60 GHz, 512 GB di RAM e quattro GPU NVIDIA Ampere A100 da 64 GB di VRAM. L'interconnessione è Infiniband Dragonfly+ da 200G HDR. È, in breve, una macchina seria.
LUMI è ospitato al CSC di Kajaani, in Finlandia. Si definisce "The Supercomputer of the North," e per i numeri che esprime se lo guadagna. Per noi, la cosa critica è che la partizione GPU di LUMI è costruita interamente su hardware AMD — il che significa ROCm, non CUDA.
Cosa stiamo facendo su Leonardo
Il lavoro principale su Leonardo è il nostro primo modello verticale: Legal IT.
L'obiettivo è un modello 7B addestrato su giurisprudenza italiana selezionata, il codice civile e il corpus normativo UE — un modello che capisce i contratti, le valutazioni GDPR e le questioni di conformità UE in un modo che un generalista da 70B non può. Non perché sia più grande, ma perché ogni parametro è rilevante.
La pipeline è: un modello frontier open-weight da 70B come insegnante, structural pruning per rimuovere la capacità irrilevante al ragionamento giuridico, knowledge distillation nel modello studente da 7B, quantizzazione per l'efficienza in inferenza, e identity fine-tuning per persona e istruzioni. La pipeline Forge, in altre parole, girata su ferro vero.
Prima di arrivare al training, volevamo verificare che EULLM Engine fosse in grado di pilotare davvero l'hardware. Abbiamo quindi fatto girare un modello da 27B su tutte e quattro le A100 di un singolo nodo. Ha funzionato. Il percorso di inferenza multi-GPU — basato su CUDA, con il batching e la gestione della memoria propri di EULLM — ha gestito un GGUF da 27B senza problemi, con i prevedibili guadagni di throughput dalla distribuzione dei pesi del modello su quattro schede da 64 GB.
È un dato significativo. Ci dice che quando Legal IT 7B sarà disponibile, un'organizzazione europea con un singolo nodo 4×A100 (on-premise o cloud) potrà farlo girare comodamente — con margine per servire utenti concorrenti.
Cosa stiamo facendo su LUMI
LUMI è una sfida diversa. La partizione GPU di LUMI usa acceleratori AMD Instinct, il che vuol dire che lo stack rilevante è ROCm, non CUDA.
Questo conta più di quanto potrebbe sembrare. "Gira su GPU" non è un monolite. Codice che funziona perfettamente su schede NVIDIA può non compilare, andare in crash, o girare con performance scadenti su hardware AMD. EULLM Engine già distribuisce il supporto ROCm — lo abbiamo segnato come sperimentale nelle release notes — ma sperimentale non è validato.
LUMI è dove lo validiamo sul serio. L'obiettivo è far girare lo stack di inferenza di EULLM su più GPU AMD e confermare che throughput, correttezza e stabilità reggono sotto carico reale. Usiamo gli stessi pesi dei modelli, la stessa API, su silicio radicalmente diverso.
Perché questo conta per la sovranità AI europea? Perché il lock-in sull'hardware è una forma di dipendenza. Se EULLM funziona in modo affidabile solo su NVIDIA, le organizzazioni europee che girano su infrastruttura AMD — e ci sono deployment AMD significativi nelle reti HPC e di ricerca europee — restano escluse. LUMI ci dà un ambiente AMD multi-GPU reale su cui lavorare invece di un simulatore o una macchina di test con una sola scheda.
Perché EuroHPC
Avremmo potuto affittare tempo GPU da un hyperscaler americano. Non l'abbiamo fatto.
I sistemi EuroHPC sono infrastruttura pubblica europea. I dati su cui calcoliamo rimangono in giurisdizione europea. Il processo di assegnazione è competitivo e basato sul merito — si presenta una descrizione del progetto, si spiega cosa si sta costruendo e perché serve il calcolo, e una commissione decide. Riteniamo ci sia qualcosa di giusto nel costruire uno stack AI sovrano europeo su calcolo sovrano europeo.
C'è anche un argomento pratico: l'hardware di Leonardo e LUMI è genuinamente eccellente. Quattro schede A100 da 64 GB per nodo non si replicano facilmente su istanze spot. La scala di GPU AMD di LUMI semplicemente non è disponibile in affitto da nessun altra parte in Europa.
Cosa viene dopo
Legal IT è una pipeline in corso. La curation del dataset è quasi completata. Le sessioni di pruning e distillation avverranno nelle prossime settimane su Leonardo. Quando il modello 7B supererà le nostre soglie interne di qualità — e la scheda di conformità AI Act sarà redatta — entrerà nell'Hub.
Per LUMI: le sessioni di validazione multi-GPU ROCm sono in corso. Pubblicheremo una nota tecnica con i benchmark quando i risultati saranno abbastanza solidi da poterli sostenere.
Se state costruendo su infrastruttura europea e volete sapere quando Legal IT sarà disponibile, il posto migliore da seguire è il nostro GitHub. Issue, discussioni e release notes avvengono tutte lì, in pubblico.
Stiamo costruendo questo allo scoperto, su macchine europee, per casi d'uso europei. Questo è l'intero punto.