Draai AI waar uw data zich bevindt.
EuLLM Engine is een open-source runtime voor grote taalmodellen. Eén Rust-binary, OpenAI- en Ollama-compatibel, nul telemetrie. Van een Raspberry Pi tot een NVIDIA GH200 of een AMD Instinct MI250X.
Uw modellen. Uw infrastructuur. Uw data.
$ curl -fsSL https://raw.githubusercontent.com/eullm/eullm/main/installer/install.sh | sh
$ eullm run hf.co/Qwen/Qwen3-8B-GGUF:Q4_K_M
Eén runtime. Eén platform om op voort te bouwen.
Engine draait modellen overal. Forge en Hub bouwen en distribueren de modellen die u specialiseert.
Engine
Een open-source runtime voor grote taalmodellen. Eén binary, OpenAI- en Ollama-compatibel, nul telemetrie.
Lees de Engine-documentatie →Forge — specialiseren
Fine-tune, destilleer en evalueer open modellen op uw data. Kleine specialisten die precies antwoorden vanuit uw documenten en bronnen, geëxporteerd als een GGUF die u bezit en draait op Engine.
Verken het PlatformHub — distribueren
Publiceer, versieer en ontdek modellen, elk met een modelkaart en een compliancekaart. Self-hostable, met een EU-gehoste regio.
Verken het PlatformOpen source, gebouwd in Europa
EuLLM is open source (AGPL-3.0) en gebouwd in Milaan door I3K Technologies. We trainen en benchmarken op de EuroHPC-supercomputers Leonardo, LUMI en JUPITER. Gebouwd in Europa, voor u om overal te draaien.
Datasoevereiniteit →
Van open model naar specialist, tot productie
Specialiseren
Forge finetunet en distilleert een open-weight model op uw eigen data.
Evalueren
Held-out benchmarks meten de nauwkeurigheid voordat er iets wordt uitgebracht.
Publiceren
Hub versiet het met een modelkaart en een compliance-kaart.
Draaien
Engine draait het overal — laptop, server of edge.
Waarom EuLLM Engine
- ~10 ms
- per beslissing
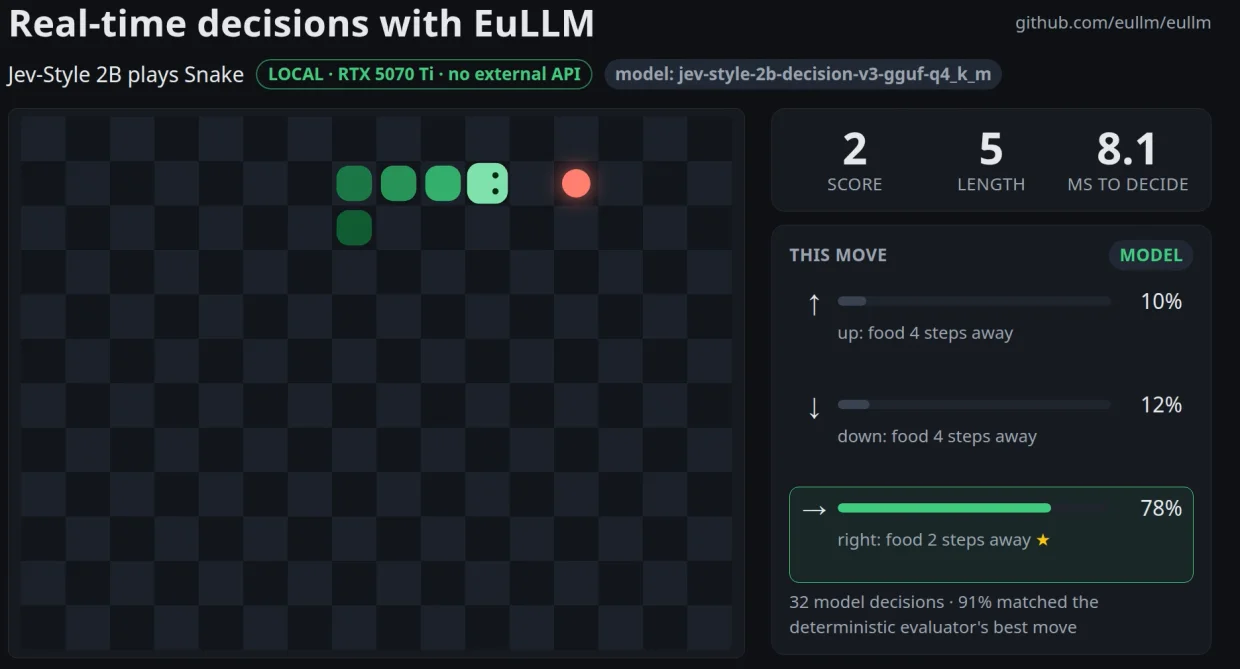
- 2B-model dat elke Snake-zet beslist op een RTX 5070 Ti
- 1,065 tok/s
- over 16 gelijktijdige gebruikers
- op één RTX 5070 Ti, 8.1× één verzoek
- 10.8 tok/s
- 35B MoE, alleen CPU
- op een 20 W ARM-board (Radxa Orion O6)
- CUDA · ROCm · Vulkan · Metal · CPU
- Draait overal
- één engine, elke backend
Privé standaard
Prompts, documenten en antwoorden verlaten nooit uw machine. Geen telemetrie, geen externe API.
Drop-in vervanging
Ollama- en OpenAI-API's op poort 11434. Open WebUI, LangChain, n8n en elke OpenAI-client werken ongewijzigd.
Snel waar het telt
Continue batching, gekwantiseerde KV-cache voor lange contexten, grote MoE-modellen op kleine GPU's.
Beslissingen, niet alleen tekst
/v1/systemone leest de waarschijnlijkheid van elke optie rechtstreeks uit het model: gestructureerde beslissingen in milliseconden, voor routering, triage en agents.
Draait overal
Laptop, werkstation, on-prem server, edge-apparaat, private cloud. Eén binary, geen Python, geen Docker vereist.
Ingebouwd audittrail
Elk verzoek wordt lokaal gelogd in een bestand dat u zelf beheert, klaar voor uw auditors.
Er is een ingebouwde chat-UI, op localhost:11435.
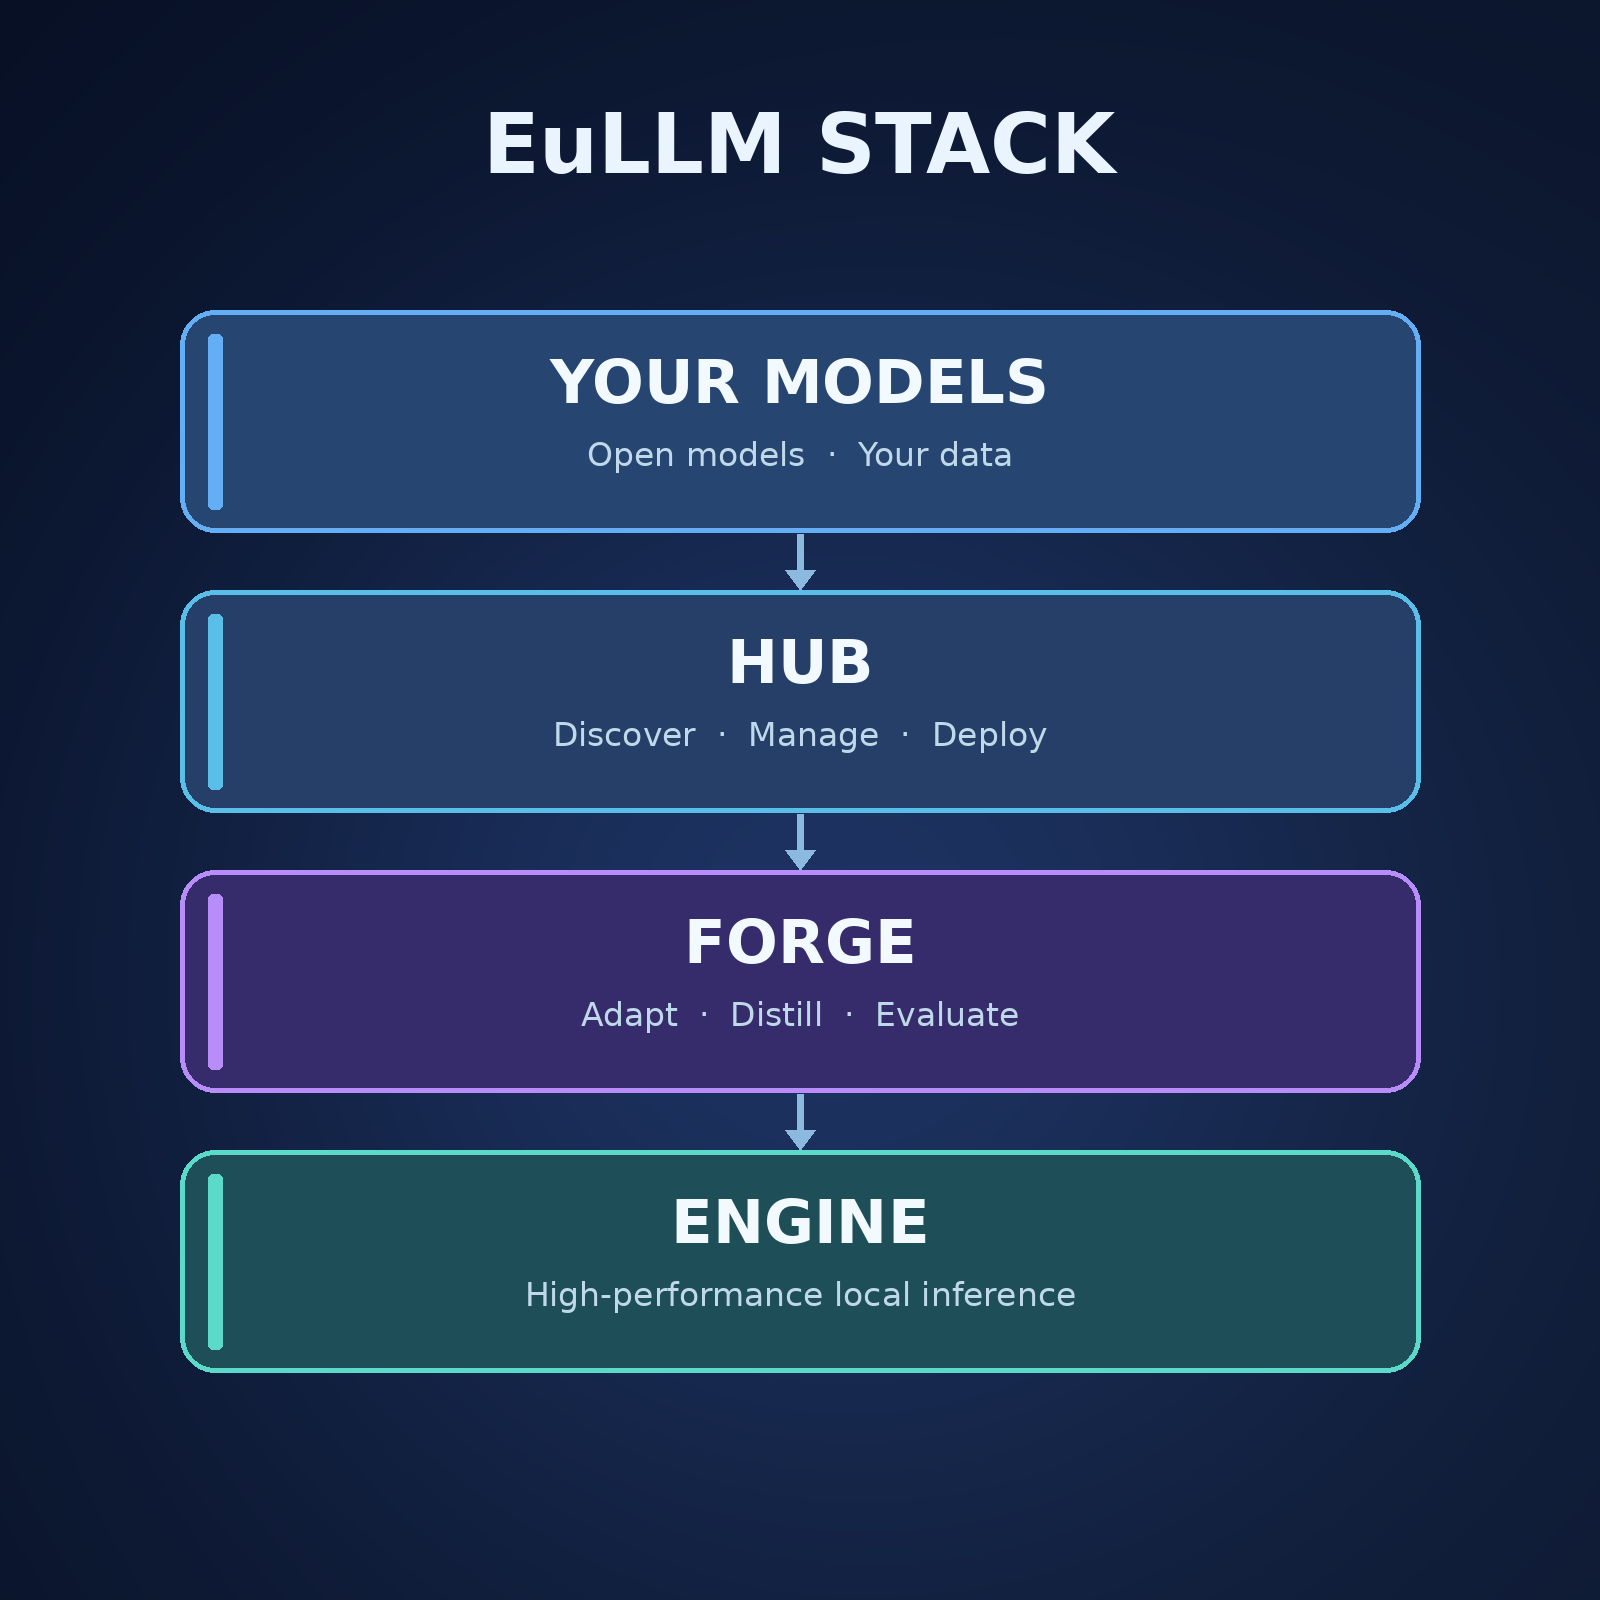
Eén stack, drie lagen
Specialistische modellen die u bezit, gebouwd op een open platform, bediend door een runtime die overal draait.
Uw modellen
Gespecialiseerd, geëvalueerd, en van u om uit te voeren — GGUF-bestanden die volledig uw eigendom zijn.
Hub — distribueren
PrototypePubliceer, versieer en ontdek modellen, elk met een modelkaart en een compliancekaart. Self-hostable, met een EU-gehoste regio.
Forge — specialiseren
In ontwikkelingFine-tune, destilleer en evalueer open modellen op uw data. Kleine specialisten die precies antwoorden vanuit uw documenten en bronnen, geëxporteerd als een GGUF die u bezit en draait op Engine.
Engine
Draait elk GGUF-model, op elke hardware, met nul telemetrie.
Gepubliceerd: legal-it-4b en legal-it-8b voor Italiaans recht, geëvalueerd op 429 achtergehouden vragen.
Open source. Door u uitgevoerd. Door iedereen verbeterd.
Open, overal waar u al werkt
EuLLM sluit aan op de tools en infrastructuur die u al gebruikt.

GitHub
Open source, AGPL-3.0. Elke regel controleerbaar.
Hugging Face
Gepubliceerde specialistische modellen, klaar om te downloaden.
I3K RAG Engine
Retrievalsysteem gebouwd voor de specialistische modellen van EuLLM.
EuroHPC
Getraind en getest op Leonardo, LUMI en JUPITER.
Gebouwd voor gereguleerd werk
Juridische zaken, zorg, financiën en overheid kunnen hun data niet toevertrouwen aan de API van een ander. EuLLM draait volledig op infrastructuur die u zelf beheert, logt elk verzoek lokaal en levert model- en compliancekaarten bij elk Platform-model.
- Lokaal audittrail voor elke inferentie
- Documentatieondersteuning voor de EU AI Act en GDPR
- Specialistische modellen voor juridisch, medisch en financieel werk (juridisch eerst)
- EU-gehoste Hub-regio voor organisaties die dat vereisen
Geen enkele binary of compliancekaart maakt op zich een systeem compliant: compliance is een eigenschap van het hele systeem en de bijbehorende governance.
Nieuwste artikelen
29 september 2026 · 6 min read
Van tokens naar beslissingen: een 2B Jev-style Decision Model lokaal draaien met EuLLM
Een 2B Jev-style Decision Model dat lokaal draait met EuLLM neemt realtime beslissingen in ongeveer 10 ms op een RTX 5070 Ti, zonder externe API.
Lees meer →
12 september 2026 · 4 min read
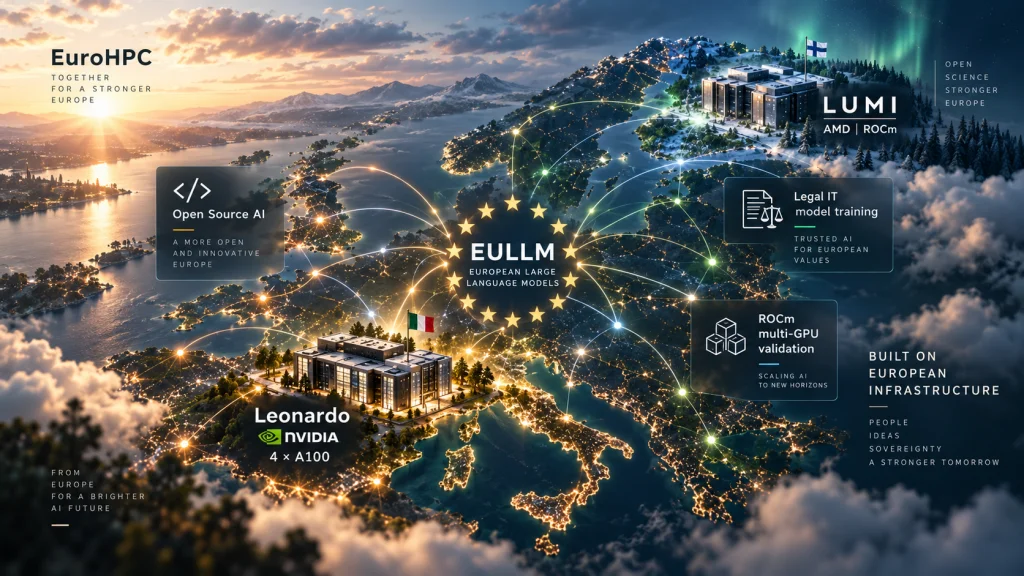
We kregen tijd op Leonardo en LUMI. Dit is wat we bouwen.
EULLM heeft rekentijd gekregen op twee EuroHPC-supercomputers: Leonardo in Bologna en LUMI in Finland. We bouwen ons eerste verticale model op A100's en valideren ROCm multi-GPU op het grootste AMD-cluster van het continent.
Lees meer →
Uw modellen. Uw infrastructuur. Uw data.
Installeer EuLLM Engine met één commando, of neem contact met ons op over een specialistisch model voor uw domein.