Twee weken geleden logden we in op twee terminals die er heel anders uitzagen dan onze gebruikelijke ontwikkelmachines. De ene verwelkomde ons met een ASCII-art-banner "LEONARDO" en een SLURM-wachtrij. De andere, een "LUMI" in pixel-blokletters, beschreef zichzelf als "The Supercomputer of the North."
Beide zijn systemen van het EuroHPC Joint Undertaking. Beide behoren tot de krachtigste computers van het continent. En beide maken nu deel uit van hoe we EULLM bouwen.
Wat we hebben gekregen
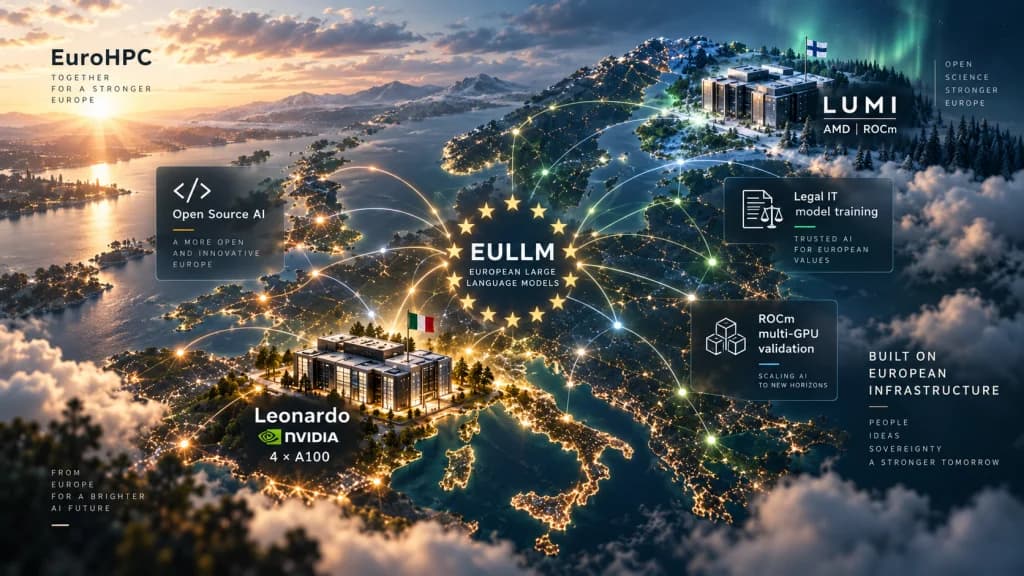
Leonardo is ondergebracht bij Cineca in Bologna, Italië. De boostermodule waartoe we toegang hebben, beschikt over 3.456 rekenknooppunten, elk met 32 Ice Lake-kernen op 2,60 GHz, 512 GB RAM en vier NVIDIA Ampere A100 GPU's met 64 GB VRAM. De interconnectie is 200G HDR Infiniband Dragonfly+. Kortom: een serieuze machine.
LUMI is ondergebracht bij CSC in Kajaani, Finland. Het noemt zichzelf "The Supercomputer of the North" — en de cijfers rechtvaardigen die titel. Cruciaal voor ons: de GPU-partitie van LUMI is volledig gebouwd op AMD-hardware — wat ROCm betekent, niet CUDA.
Wat we doen op Leonardo
Het hoofdwerk op Leonardo is ons eerste verticale model: Legal IT.
Het doel is een 7B-specialist getraind op gecureerde Italiaanse jurisprudentie, het burgerlijk wetboek en het EU-regelgevingscorpus — een model dat contracten, GDPR-beoordelingen en EU-nalevingsvragen begrijpt op een manier die een algemeen 70B-model niet kan. Niet omdat het groter is, maar omdat elk parameter relevant is.
De pipeline: een frontier open-weight 70B-model als docent, structural pruning om voor juridisch redeneren irrelevante capaciteit te verwijderen, knowledge distillation in de 7B-student, kwantisering voor inferentie-efficiëntie, en identity fine-tuning voor persona en instructies. De Forge-pipeline, kortom, gedraaid op echt ijzer.
Voordat we met training begonnen, wilden we verifiëren dat EULLM Engine de hardware daadwerkelijk kon aansturen. We hebben daarom een 27B-model laten draaien op alle vier A100's van één knooppunt. Het werkte. Het multi-GPU-inferentiepad — CUDA-gebaseerd, met EULLMs eigen batching en geheugenbeheer — verwerkte een 27B GGUF probleemloos, met de verwachte doorvoerwinsten van het verdelen van modelgewichten over vier 64 GB-kaarten.
Dat is een betekenisvolle datapunt. Het vertelt ons dat wanneer Legal IT 7B beschikbaar is, een Europese organisatie met één 4×A100-knooppunt (on-premise of cloud) het comfortabel kan draaien — met ruimte om gelijktijdige gebruikers te bedienen.
Wat we doen op LUMI
LUMI is een andere uitdaging. De GPU-partitie van LUMI gebruikt AMD Instinct-accelerators, wat betekent dat de relevante stack ROCm is, niet CUDA.
Dit is belangrijker dan het lijkt. "Draait op GPU" is geen monoliet. Code die perfect werkt op NVIDIA-kaarten compileert mogelijk niet, kan crashen, of draait met slechte prestaties op AMD-hardware. EULLM Engine levert al ROCm-ondersteuning — we hebben het als experimenteel gemarkeerd in de release notes — maar experimenteel is niet gevalideerd.
LUMI is waar we het goed valideren. Het doel: EULLMs inferentiestack draaien op meerdere AMD GPU's en bevestigen dat doorvoer, correctheid en stabiliteit standhouden onder echte belasting. We gebruiken dezelfde modelgewichten, hetzelfde API-oppervlak, op radicaal ander silicium.
Waarom is dit belangrijk voor Europese AI-soevereiniteit? Omdat hardware-lock-in een vorm van afhankelijkheid is. Als EULLM alleen betrouwbaar werkt op NVIDIA, worden Europese organisaties die AMD-infrastructuur draaien — en er zijn aanzienlijke AMD-deployments in Europese HPC- en onderzoeksnetwerken — uitgesloten. LUMI geeft ons een echte multi-GPU AMD-omgeving in plaats van een simulator of een testmachine met één kaart.
Waarom EuroHPC
We hadden GPU-tijd kunnen huren bij een Amerikaanse hyperscaler. Dat hebben we niet gedaan.
EuroHPC-systemen zijn Europese publieke infrastructuur. De data waarop we rekenen blijft binnen de Europese jurisdictie. Het toewijzingsproces is competitief en meritocratisch — je dient een projectbeschrijving in, legt uit wat je bouwt en waarom het de rekenkracht nodig heeft, en een commissie beslist. We vinden er iets juists in om een Europese soevereine AI-stack te bouwen op Europese soevereine compute.
Er is ook een praktisch argument: de hardware bij Leonardo en LUMI is ronduit uitstekend. Vier A100 64GB-kaarten per knooppunt is niet iets wat je gemakkelijk kunt repliceren op spot-instances. De schaal van AMD GPU's bij LUMI is simpelweg nergens anders in Europa te huur.
Wat er hierna komt
Legal IT is een pipeline in uitvoering. De datasetcuratie is bijna klaar. De pruning- en distillation-sessies vinden de komende weken op Leonardo plaats. Wanneer het 7B-model onze interne kwaliteitsdrempels haalt — en de AI Act-compliancekaart is opgesteld — gaat het de Hub in.
Voor LUMI: ROCm multi-GPU validatiesessies zijn gaande. We publiceren een technische notitie met benchmarks wanneer de resultaten solide genoeg zijn om achter te staan.
Als u bouwt op Europese infrastructuur en wilt weten wanneer Legal IT beschikbaar is, is de beste plek om te volgen ons GitHub. Issues, discussies en release notes vinden daar allemaal publiekelijk plaats.
We bouwen dit openlijk, op Europese machines, voor Europese gebruiksgevallen. Dat is het hele punt.