De meeste demonstraties van large language models volgen hetzelfde patroon: je geeft het model een prompt en wacht tot het tekst genereert.
Maar tekstgeneratie is slechts één manier om een taalmodel te gebruiken.
Een klein model kan ook worden getraind of aangepast om een toestand te onderzoeken, een beperkte set mogelijke acties te evalueren en er één te kiezen. In die rol lijkt het model steeds minder op een chatbot en steeds meer op een beslissingsengine.
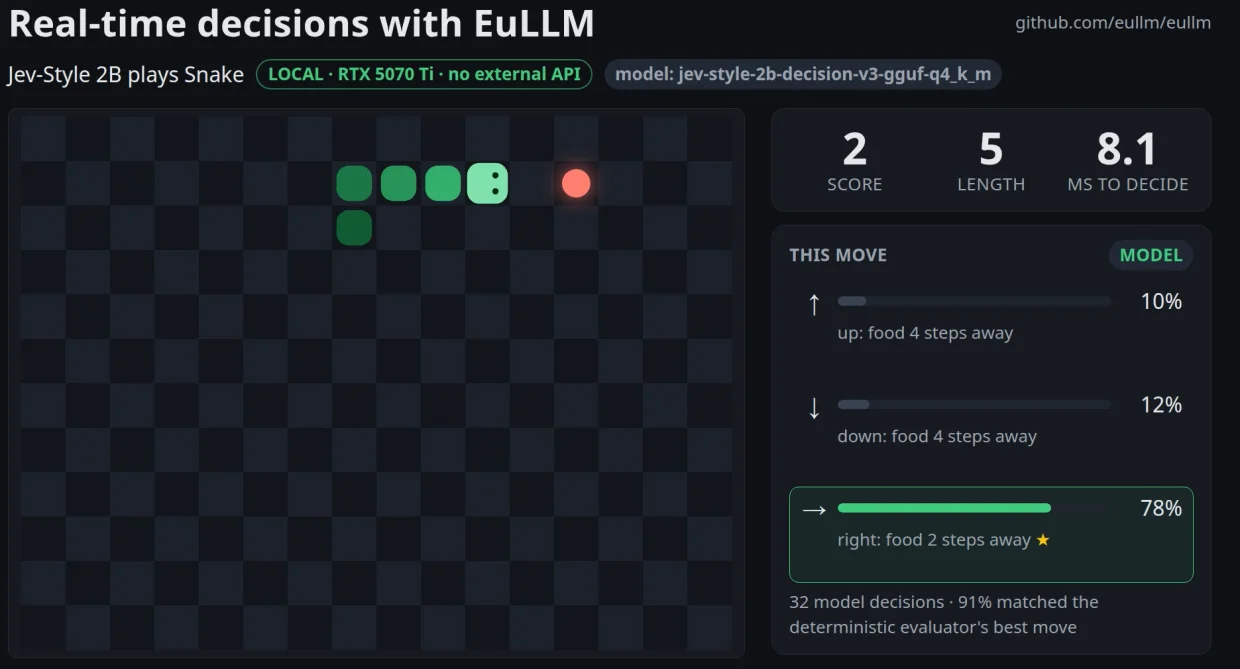
We hebben een eenvoudige demonstratie van dit idee gebouwd met een 2B Jev-style Decision Model dat lokaal draait met EuLLM.
De taak is bewust herkenbaar: Snake.
Het interessante is niet het spel. Het is wat er gebeurt tussen twee zetten.
Een beslissing in ongeveer 8 milliseconden
Bij elke stap ontvangt het model de huidige spelstatus en evalueert het de beschikbare acties.
Het hoeft geen essay te schrijven of honderden tokens te produceren. Het moet een veel smallere vraag beantwoorden: wat moet ik nu doen?
Op een NVIDIA RTX 5070 Ti neemt het model in onze test die beslissing in ongeveer 8 milliseconden.
De volledige inferentie draait lokaal via EuLLM. Geen aanroep naar een externe modelaanbieder en geen remote API betrokken in de beslissingslus.
De demo bevat ook een deterministische evaluator die onafhankelijk de beste beschikbare actie berekent op basis van de huidige toestand.
Over meer dan duizend beslissingen tijdens één run kwam ongeveer 95% van de keuzes van het model overeen met de beste zet volgens de evaluator.
Dat onderscheid is belangrijk. Het cijfer van 95% is geen generieke "nauwkeurigheidsscore" en het is geen LLM-rechter die een ander LLM beoordeelt. Het meet de overeenstemming tussen de beslissing van het model en een deterministische referentie-implementatie voor deze specifieke taak.
Waarom een LLM gebruiken voor beslissingen?
Een voor de hand liggende vraag is waarom iemand een taalmodel zou gebruiken voor een taak die met conventionele code op te lossen is.
Voor Snake zelf is er geen dwingende reden. Snake is simpelweg een visuele omgeving waarin mensen onmiddellijk kunnen begrijpen of een beslissing goed of slecht was.
De interessante toepassingen beginnen wanneer de toestand moeilijker weer te geven is met een vaste regelset.
Stel je een enterprise-agent voor die documenten heeft opgehaald, een klantverzoek heeft bekeken en twee tools heeft aangeroepen. Nu moet hij bepalen of hij antwoordt, meer bewijs ophaalt, een andere tool aanroept, of de taak escaleert naar een mens. Dat is een beslissingsprobleem.
Een beveiligingssysteem moet mogelijk beslissen of een gebeurtenis genegeerd, gecorreleerd met eerdere activiteit, onderzocht of geëscaleerd moet worden.
Een RAG-pipeline moet mogelijk beslissen of het momenteel opgehaalde bewijs voldoende is om een vraag te beantwoorden.
Een industrieel systeem moet mogelijk de volgende actie kiezen op basis van telemetrie, bedrijfsomstandigheden en tekstuele instructies.
De output kan in elk van deze gevallen extreem klein zijn, zelfs wanneer de input complex is. Dat verandert de economie van inferentie.
Kleine modellen hoeven zich niet altijd als kleine chatbots te gedragen
De sector heeft de neiging kleine modellen te beoordelen op basis van hoe goed ze veel grotere general-purpose modellen kunnen nabootsen. Dat is nuttig, maar niet de enige manier om ze te gebruiken.
Een klein model kan in plaats daarvan worden gespecialiseerd rond een smalle beslissingsruimte. Als de vereiste output één actie is uit vijf mogelijkheden, is het genereren van meerdere alinea's natuurlijke taal onnodige overhead.
Dit is bijzonder relevant voor lokale AI. Een 2B-model is klein genoeg om te draaien op breed beschikbare hardware, terwijl het nog steeds groot genoeg is om aanzienlijk rijkere input te interpreteren dan een traditionele classifier.
De nuttige vergelijking is dus niet altijd klein model versus groot model, maar soms gespecialiseerd model versus remote general-purpose inferentie voor elke beslissing.
Voor toepassingen die honderden of duizenden beslissingen nemen, worden latentie en infrastructuurvereisten snel significant.
Waar EuLLM past
EuLLM is geen model. Het is een open platform ontworpen rond lokale en Europese AI-infrastructuur.
Het project bestaat uit drie elkaar aanvullende onderdelen.
EuLLM Engine biedt de runtime waarmee modellen lokaal worden uitgevoerd.
EuLLM Forge richt zich op modelspecialisatie, verticalisatie en teacher-student-workflows.
EuLLM Hub wordt ontwikkeld als een Europees modelregister en distributielaag, inclusief model- en compliance-informatie.
Het Snake-experiment betreft vooral de Engine-kant: een klein gekwantiseerd decision model dat lokaal draait en reageert met zeer lage latentie.
Maar de combinatie op langere termijn is interessanter. Een groter teacher-model kan helpen om via Forge kleinere gespecialiseerde modellen te produceren. Die modellen kunnen vervolgens door Engine worden uitgevoerd, dicht bij de applicaties die ze gebruiken.
Dat is bijzonder aantrekkelijk wanneer inferentie privé, voorspelbaar en goedkoop moet blijven.
Decision models en AI-agents
Een van de meest voor de hand liggende toepassingen is agentic AI.
Huidige agents sturen vaak relatief eenvoudige controlebeslissingen naar grote, externe modellen:
- Moet de agent opnieuw zoeken?
- Welke tool moet hij aanroepen?
- Beantwoordt het huidige bewijs de vraag van de gebruiker?
- Moet de taak worden geëscaleerd?
Deze beslissingen vereisen vaak contextbegrip, maar niet noodzakelijk een zeer groot generatief model.
Een klein lokaal decision model kan mogelijk deel uitmaken van het besturingsvlak, waarbij dure generatieve inferentie wordt bewaard voor de situaties waarin dat echt nodig is.
Dezelfde architectuur kan worden toegepast op RAG-pipelines. Retrieval hoeft geen vaste reeks van zoeken, reranken en genereren te zijn. Een model kan de kwaliteit van de retrieval onderzoeken en bepalen of een nieuwe zoekopdracht gerechtvaardigd is, of een andere bron moet worden geraadpleegd, of dat het vertrouwen voldoende is om door te gaan.
Ook hier is de output een beslissing in plaats van een document.
Lokale uitvoering verandert het latentiebudget
Een beslissing van 8 ms is niet belangrijk simpelweg omdat het getal klein is. Het verandert welke toepassingen praktisch worden.
Als elke stap van een geautomatiseerde workflow een remote HTTP-verzoek naar een externe inferentiedienst vereist, stapelt de latentie zich op. Netwerkvariabiliteit en de beschikbaarheid van de dienst worden onderdeel van de controlelus.
Lokale inferentie elimineert die heen-en-terugreis. Het betekent ook dat de onderliggende informatie de machine waarop de applicatie draait niet hoeft te verlaten.
Voor enterprise-omgevingen kunnen deze eigenschappen net zo relevant zijn als de modelkwaliteit zelf.
Snake is de visualisatie, niet het doel
We kozen voor Snake omdat de beslissingslus zichtbaar is. Je kunt het model de toestand zien onderzoeken, een actie zien kiezen en direct het gevolg zien.
Hetzelfde mechanisme wordt visueel minder spectaculair — maar potentieel veel waardevoller — wanneer de acties dingen zijn zoals:
retrieve_morecall_toolapproveescalateroute_to_departmentinvestigate_eventcontinue_workflow
Dat is waar kleine decision models interessant worden.
Het experiment suggereert een bredere richting voor EuLLM: lokale AI-infrastructuur hoeft niet uitsluitend rond chat completion te worden ontworpen.
Soms is de nuttigste output die een LLM kan produceren geen zin.
Het is de volgende actie.
EuLLM is open source: github.com/eullm/eullm
Project: eullm.eu