Execute IA onde os seus dados residem.
O EuLLM Engine é um runtime open-source para modelos de linguagem de grande escala. Um único binário em Rust, compatível com OpenAI e Ollama, zero telemetria. De um Raspberry Pi a uma NVIDIA GH200 ou uma AMD Instinct MI250X.
Os seus modelos. A sua infraestrutura. Os seus dados.
$ curl -fsSL https://raw.githubusercontent.com/eullm/eullm/main/installer/install.sh | sh
$ eullm run hf.co/Qwen/Qwen3-8B-GGUF:Q4_K_M
Um runtime. Uma plataforma para construir sobre ele.
O Engine executa modelos em qualquer lugar. O Forge e o Hub constroem e distribuem os que especializa.
Engine
Um runtime open-source para modelos de linguagem de grande escala. Um único binário, compatível com OpenAI e Ollama, zero telemetria.
Ler a documentação do Engine →Forge — especializar
Ajuste fino, destile e avalie modelos abertos com os seus dados. Pequenos especialistas que respondem com precisão a partir dos seus documentos e fontes, exportados como um GGUF que é seu e que corre no Engine.
Explorar a PlatformHub — distribuir
Publique, faça versionamento e descubra modelos, cada um com um cartão de modelo e um cartão de conformidade. Pode ser auto-alojado, com uma região alojada na UE.
Explorar a PlatformOpen source, construído na Europa
O EuLLM é open source (AGPL-3.0) e construído em Milão pela I3K Technologies. Treinamos e avaliamos em supercomputadores EuroHPC, Leonardo, LUMI e JUPITER. Construído na Europa, seu para executar em qualquer lugar.
Soberania de dados →
De modelo aberto a especialista, até à produção
Especializar
O Forge afina e destila um modelo open-weight com os seus próprios dados.
Avaliar
Testes held-out medem a precisão antes de qualquer publicação.
Publicar
O Hub versiona-o com um cartão de modelo e um cartão de conformidade.
Executar
O Engine executa-o em qualquer lugar — portátil, servidor ou edge.
Porquê o EuLLM Engine
- ~10 ms
- por decisão
- Modelo de 2B a decidir cada movimento do Snake numa RTX 5070 Ti
- 1,065 tok/s
- com 16 utilizadores simultâneos
- numa única RTX 5070 Ti, 8.1× um único pedido
- 10.8 tok/s
- 35B MoE, apenas CPU
- numa placa ARM de 20 W (Radxa Orion O6)
- CUDA · ROCm · Vulkan · Metal · CPU
- Corre em qualquer lugar
- um único motor, todos os backends
Privado por definição
Os prompts, documentos e respostas nunca saem da sua máquina. Sem telemetria, sem API externa.
Substituto direto
APIs Ollama e OpenAI na porta 11434. Open WebUI, LangChain, n8n e qualquer cliente OpenAI funcionam sem alterações.
Rápido onde importa
Batching contínuo, cache KV quantizada para contextos longos, modelos MoE grandes em GPUs pequenas.
Decisões, não apenas texto
/v1/systemone lê diretamente do modelo a probabilidade de cada opção: decisões estruturadas em milissegundos, para routing, triagem e agentes.
Corre em qualquer lugar
Portátil, workstation, servidor on-prem, dispositivo edge, cloud privada. Um único binário, sem necessidade de Python ou Docker.
Registo de auditoria integrado
Cada pedido é registado localmente num ficheiro que controla, pronto para os seus auditores.
Uma interface de chat está incorporada, em localhost:11435.
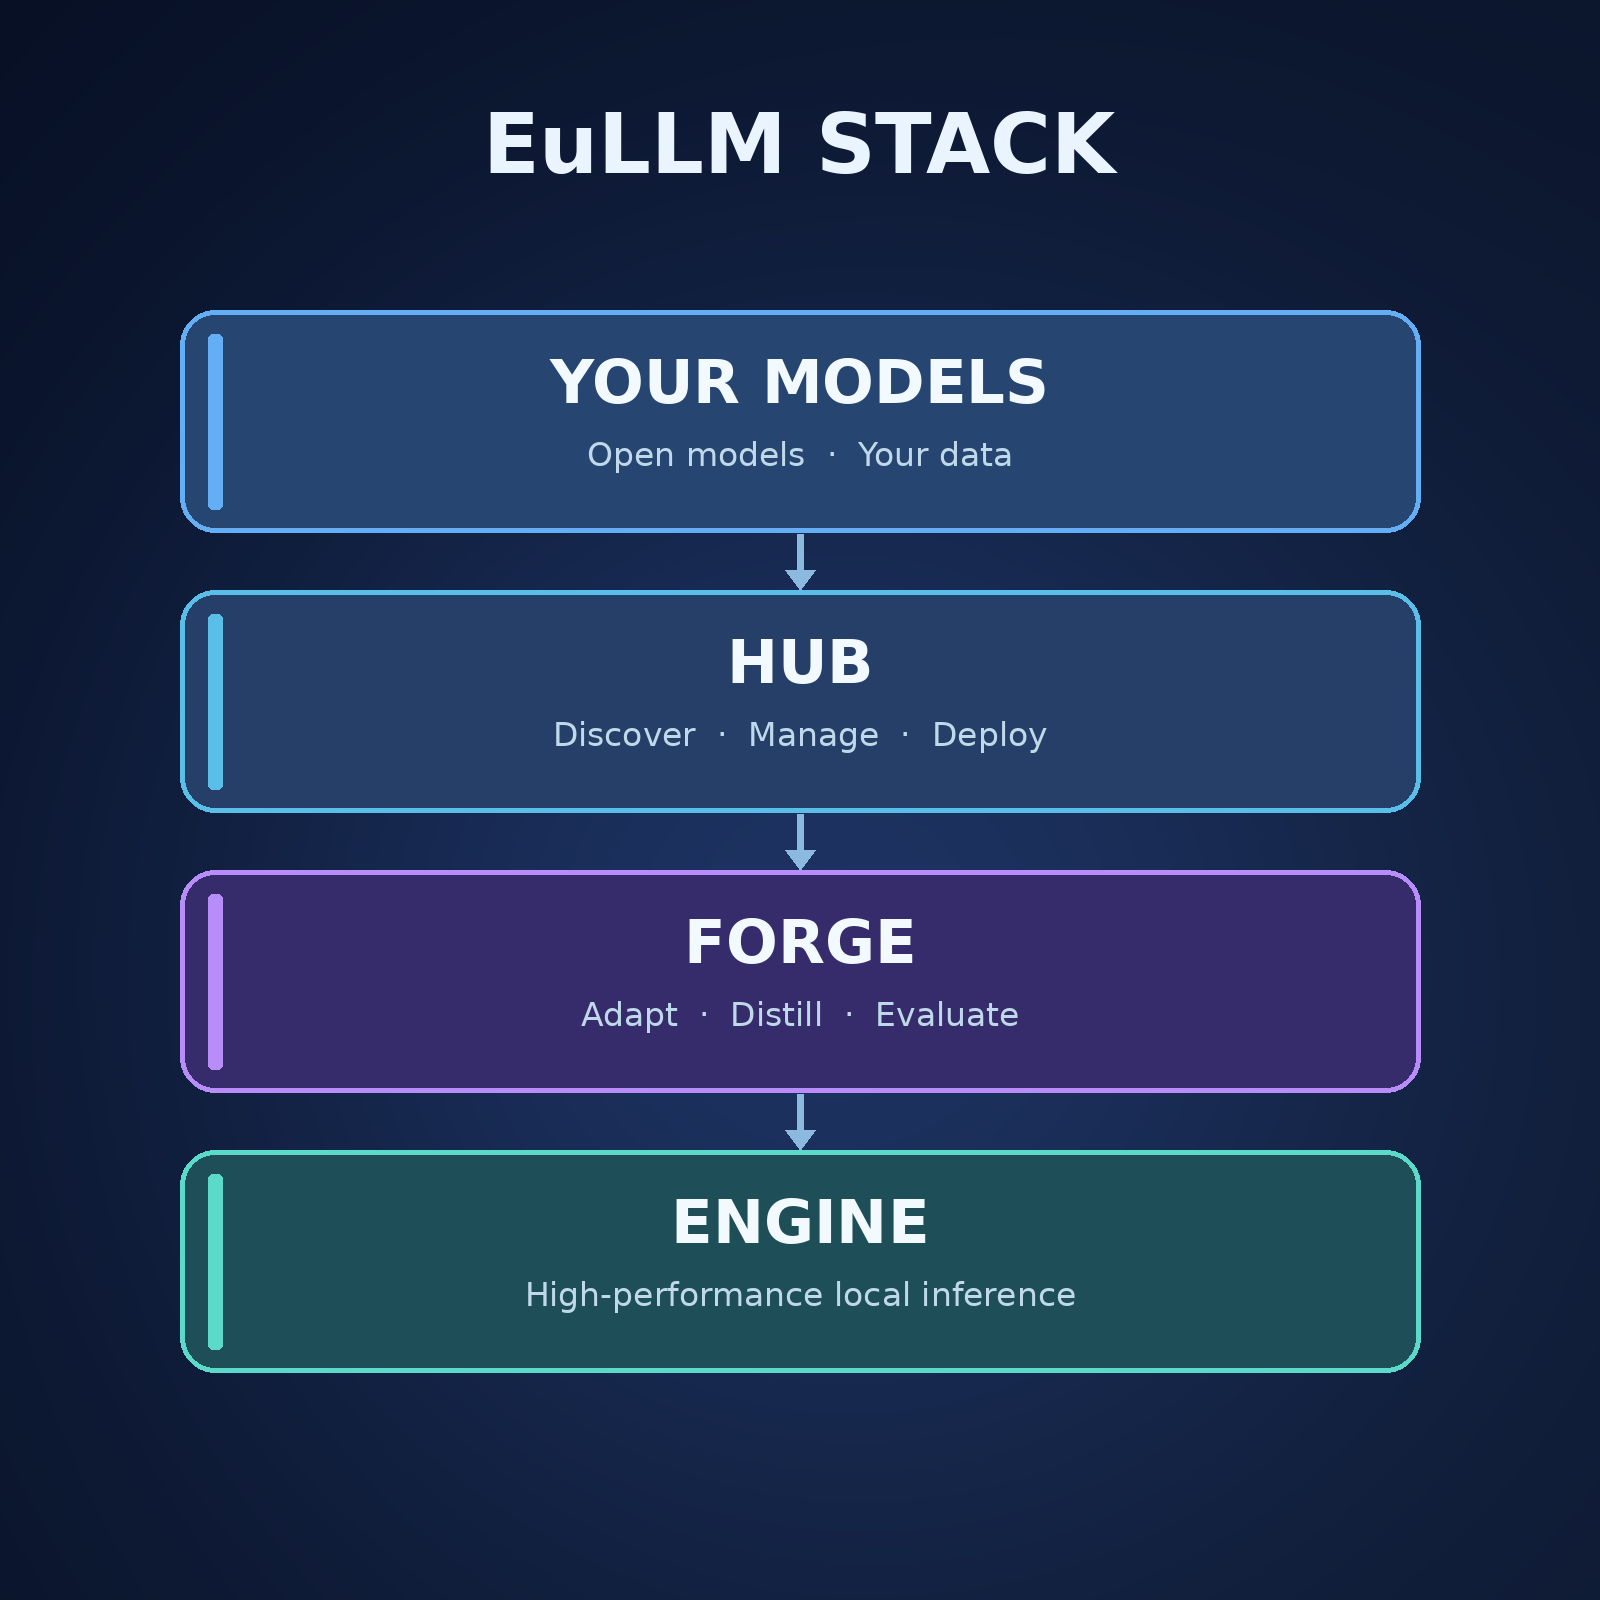
Uma pilha, três camadas
Modelos especialistas que são seus, construídos sobre uma plataforma aberta, servidos por um runtime que corre em qualquer lugar.
Os seus modelos
Especializados, avaliados, e seus para executar — ficheiros GGUF que possui integralmente.
Hub — distribuir
ProtótipoPublique, faça versionamento e descubra modelos, cada um com um cartão de modelo e um cartão de conformidade. Pode ser auto-alojado, com uma região alojada na UE.
Forge — especializar
Em desenvolvimentoAjuste fino, destile e avalie modelos abertos com os seus dados. Pequenos especialistas que respondem com precisão a partir dos seus documentos e fontes, exportados como um GGUF que é seu e que corre no Engine.
Engine
Executa qualquer modelo GGUF, em qualquer hardware, com zero telemetria.
Publicado: legal-it-4b e legal-it-8b para direito italiano, avaliados em 429 perguntas reservadas para teste.
Open source. Executado por si. Melhorado por todos.
Aberto, em todo o lado onde já trabalha
O EuLLM integra-se com as ferramentas e infraestrutura que já utiliza.

GitHub
Open source, AGPL-3.0. Cada linha verificável.
Hugging Face
Modelos especialistas publicados, prontos a descarregar.
I3K RAG Engine
Sistema de retrieval criado para os modelos especialistas do EuLLM.
EuroHPC
Treinado e avaliado no Leonardo, LUMI e JUPITER.
Concebido para trabalho regulado
Os setores jurídico, da saúde, financeiro e da administração pública não podem entregar os seus dados à API de outra empresa. O EuLLM corre inteiramente na infraestrutura que controla, regista cada pedido localmente e inclui cartões de modelo e de conformidade em cada modelo da Platform.
- Registo de auditoria local para cada inferência
- Suporte de documentação para o EU AI Act e o RGPD
- Modelos especialistas para trabalho jurídico, médico e financeiro (jurídico primeiro)
- Região do Hub alojada na UE para as organizações que o exigem
Nenhum binário ou cartão de conformidade, por si só, torna um sistema conforme: a conformidade é uma propriedade de todo o sistema e da sua governança.
Artigos mais recentes
29 de setembro de 2026 · 7 min read
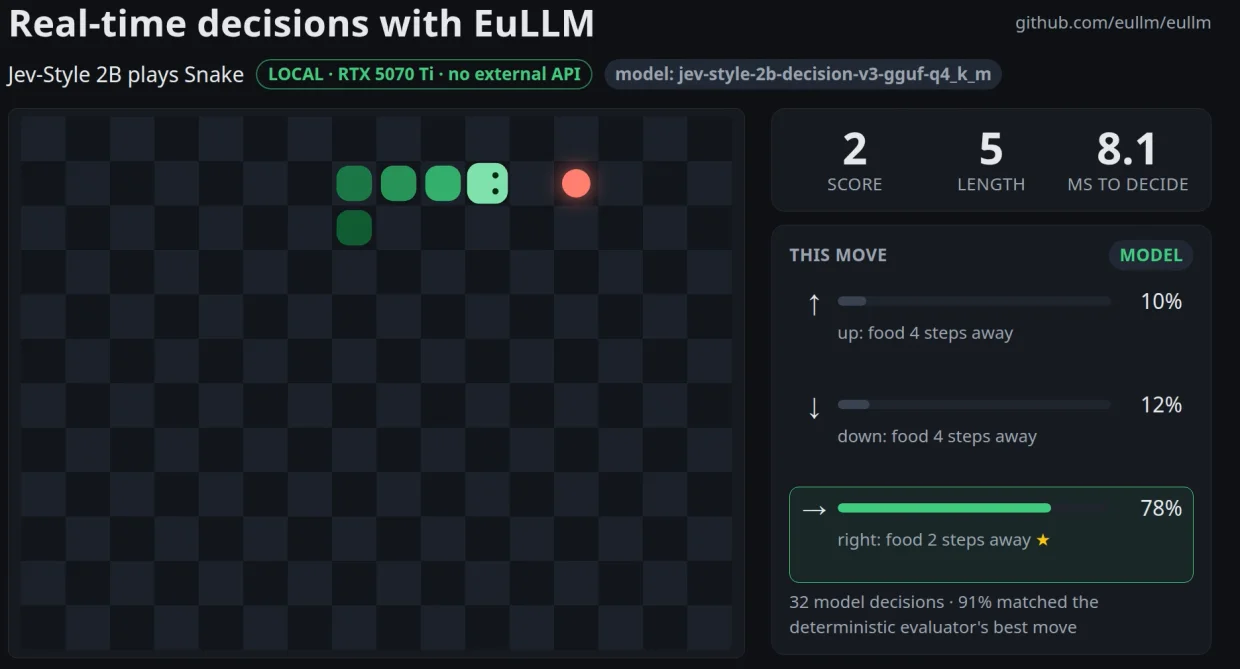
De Tokens a Decisões: Executar Localmente um Decision Model Jev-style de 2B com EuLLM
Um Decision Model Jev-style de 2B em execução local com EuLLM toma decisões em tempo real em cerca de 10 ms numa RTX 5070 Ti, sem qualquer API externa.
Ler mais →
12 de setembro de 2026 · 5 min read
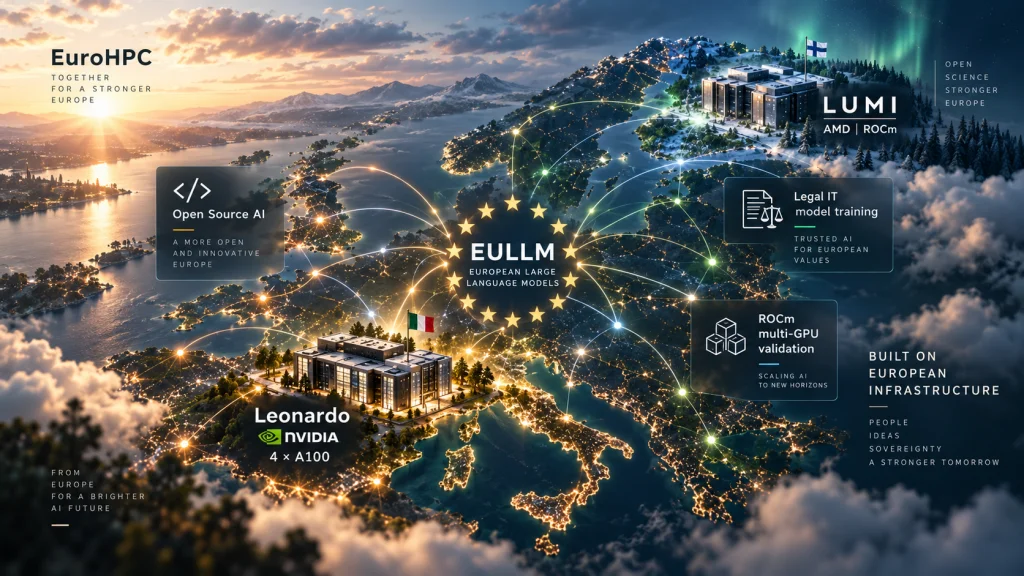
Obtivemos tempo em Leonardo e LUMI. Isto é o que estamos a construir.
A EULLM recebeu tempo de cálculo em dois supercomputadores EuroHPC: Leonardo em Bolonha e LUMI na Finlândia. Estamos a construir o nosso primeiro modelo vertical em A100 e a validar ROCm multi-GPU no maior cluster AMD do continente.
Ler mais →
Os seus modelos. A sua infraestrutura. Os seus dados.
Instale o EuLLM Engine com um único comando, ou fale connosco sobre um modelo especialista para o seu domínio.