Há duas semanas iniciámos sessão em dois terminais que pareciam muito diferentes das nossas máquinas de desenvolvimento habituais. Um acolheu-nos com um banner ASCII «LEONARDO» e uma fila SLURM. O outro, um «LUMI» em letras de blocos de píxeis, descrevia-se como «The Supercomputer of the North».
Ambos são sistemas do EuroHPC Joint Undertaking. Ambos estão entre os computadores mais poderosos do continente. E ambos fazem agora parte de como construímos a EULLM.
O que obtivémos
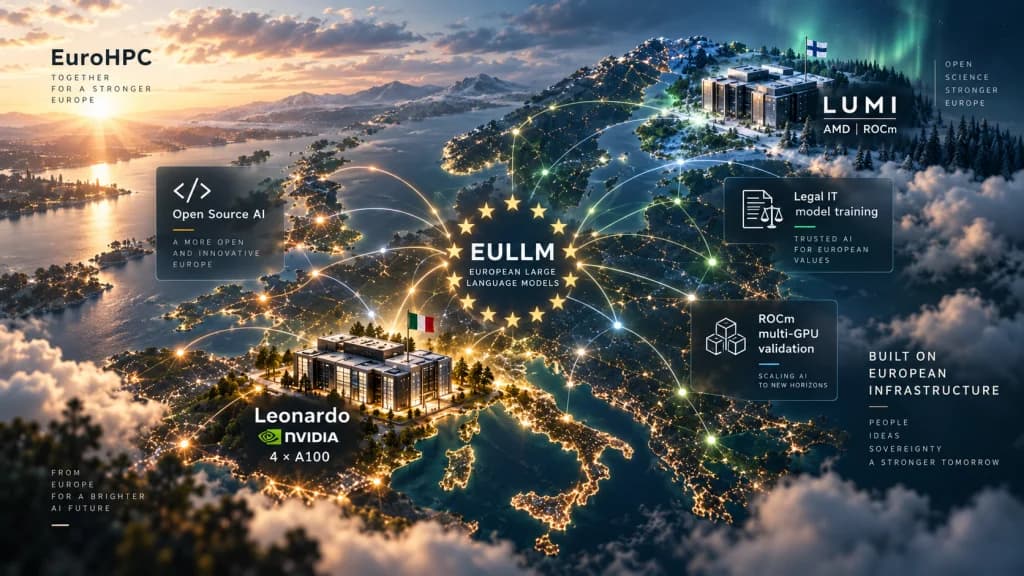
Leonardo está alojado no Cineca em Bolonha, Itália. O módulo booster ao qual temos acesso executa 3.456 nós de cálculo, cada um com 32 núcleos Ice Lake a 2,60 GHz, 512 GB de RAM e quatro GPU NVIDIA Ampere A100 com 64 GB de VRAM. A interligação é Infiniband Dragonfly+ 200G HDR. É, resumindo, uma máquina séria.
LUMI está alojado no CSC em Kajaani, Finlândia. Chama-se a si próprio «The Supercomputer of the North» — e os números justificam o título. O que é crítico para nós: a partição GPU do LUMI é construída inteiramente em hardware AMD — o que significa ROCm, não CUDA.
O que estamos a fazer no Leonardo
O trabalho principal no Leonardo é o nosso primeiro modelo vertical: Legal IT.
O objetivo é um especialista 7B treinado em jurisprudência italiana selecionada, o código civil e o corpus regulatório da UE — um modelo que compreende contratos, avaliações RGPD e questões de conformidade com a UE de uma forma que um generalista de 70B não consegue. Não porque seja maior, mas porque cada parâmetro é relevante.
O pipeline: um modelo frontier open-weight de 70B como professor, structural pruning para remover capacidade irrelevante para o raciocínio jurídico, knowledge distillation para o estudante de 7B, quantização para eficiência de inferência, e identity fine-tuning para persona e instruções. O pipeline Forge, por outras palavras, executado em ferro real.
Antes de chegar ao treino, queríamos verificar que o EULLM Engine conseguia realmente conduzir o hardware. Executámos por isso um modelo de 27B nas quatro A100 de um único nó. Funcionou. O caminho de inferência multi-GPU — baseado em CUDA, usando o batching e a gestão de memória próprios da EULLM — geriu um GGUF de 27B sem problemas, com os ganhos de débito esperados da distribuição dos pesos do modelo por quatro placas de 64 GB.
Este é um ponto de dados significativo. Diz-nos que quando o Legal IT 7B for lançado, uma organização europeia com um único nó 4×A100 (on-premise ou cloud) conseguirá executá-lo confortavelmente — com margem para servir utilizadores simultâneos.
O que estamos a fazer no LUMI
O LUMI é um desafio diferente. A partição GPU do LUMI utiliza aceleradores AMD Instinct, o que significa que o stack relevante é ROCm, não CUDA.
Isto importa mais do que pode parecer. «Corre em GPU» não é um monólito. Código que funciona perfeitamente em placas NVIDIA pode não compilar, pode falhar ou correr com fraco desempenho em hardware AMD. O EULLM Engine já inclui suporte a ROCm — marcámo-lo como experimental nas notas de versão — mas experimental não é validado.
O LUMI é onde o validamos a sério. O objetivo: executar o stack de inferência da EULLM em múltiplas GPU AMD e confirmar que o débito, a correção e a estabilidade se mantêm sob carga real. Usamos os mesmos pesos de modelos, a mesma superfície de API, em silício radicalmente diferente.
Porque é que isto importa para a soberania europeia em IA? Porque o lock-in de hardware é uma forma de dependência. Se a EULLM apenas funciona de forma fiável em NVIDIA, as organizações europeias que executam infraestrutura AMD — e existem implementações AMD significativas nas redes HPC e de investigação europeias — ficam excluídas. O LUMI dá-nos um ambiente AMD multi-GPU real em vez de um simulador ou uma máquina de teste com uma única placa.
Porque EuroHPC
Poderíamos ter alugado tempo GPU a um hyperscaler americano. Não o fizémos.
Os sistemas EuroHPC são infraestrutura pública europeia. Os dados sobre os quais calculamos permanecem dentro da jurisdição europeia. O processo de atribuição é competitivo e baseado no mérito — submete-se uma descrição do projeto, explica-se o que se está a construir e porquê precisa da capacidade de cálculo, e uma comissão decide. Pensamos que há algo certo em construir um stack de IA soberano europeu em computação soberana europeia.
Há também um argumento prático: o hardware em Leonardo e LUMI é genuinamente excelente. Quatro placas A100 de 64 GB por nó não é algo que se consiga replicar facilmente em instâncias spot. A escala de GPU AMD do LUMI simplesmente não está disponível para arrendar em nenhum outro lugar na Europa.
O que vem a seguir
O Legal IT é um pipeline em curso. A curação do conjunto de dados está quase concluída. As sessões de pruning e distillation decorrerão nas próximas semanas no Leonardo. Quando o modelo 7B passar os nossos limiares de qualidade internos — e o cartão de conformidade AI Act estiver redigido — entrará no Hub.
Para o LUMI: as sessões de validação multi-GPU ROCm estão em curso. Publicaremos uma nota técnica com benchmarks quando os resultados forem suficientemente sólidos para os podermos defender.
Se está a construir em infraestrutura europeia e quer saber quando o Legal IT estará disponível, o melhor sítio para seguir é o nosso GitHub. Issues, discussões e notas de versão acontecem lá publicamente.
Estamos a construir isto de forma aberta, em máquinas europeias, para casos de uso europeus. Esse é o ponto inteiro.