A maioria das demonstrações de grandes modelos de linguagem segue o mesmo padrão: dá-se um prompt ao modelo e espera-se que gere texto.
Mas a geração de texto é apenas uma forma de utilizar um modelo de linguagem.
Um modelo pequeno também pode ser treinado ou adaptado para examinar um estado, avaliar um conjunto limitado de ações possíveis e escolher uma delas. Nesse papel, o modelo deixa de parecer um chatbot e passa a parecer um motor de decisão.
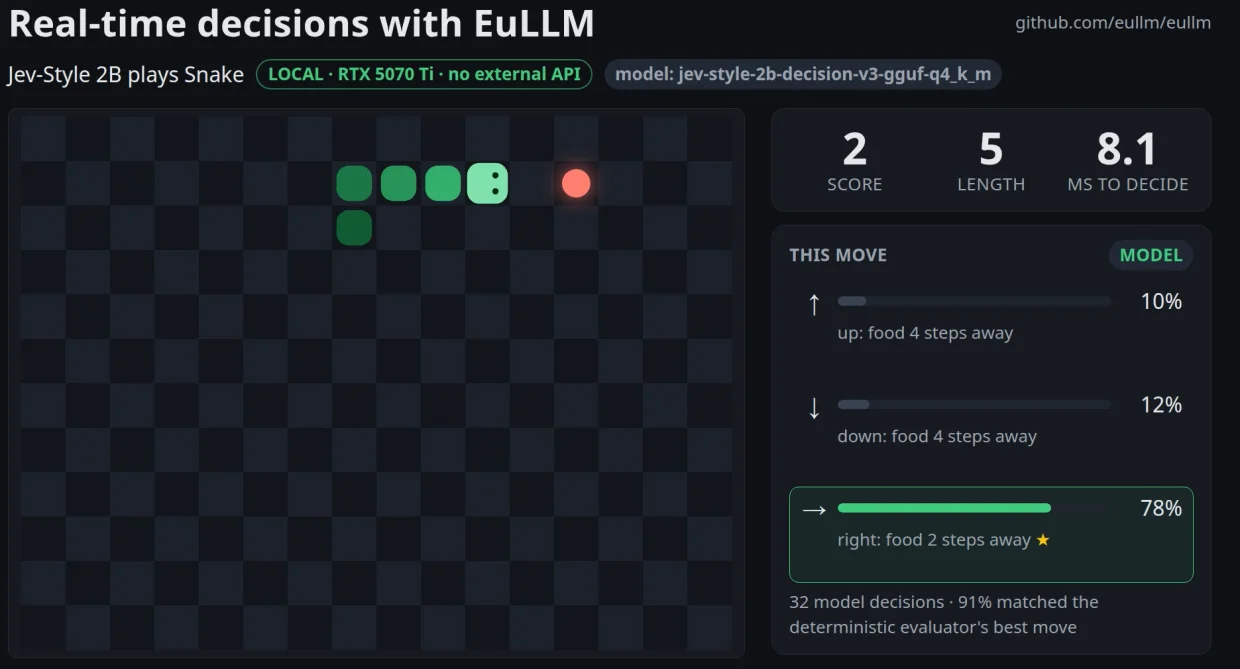
Construímos uma demonstração simples desta ideia utilizando um Decision Model Jev-style de 2B em execução local com EuLLM.
A tarefa é deliberadamente familiar: Snake.
A parte interessante não é o jogo. É o que acontece entre dois movimentos.
Uma decisão em cerca de 8 milissegundos
A cada passo, o modelo recebe o estado atual do jogo e avalia as ações disponíveis.
Não precisa de escrever um ensaio nem de produzir centenas de tokens. Precisa de responder a uma questão muito mais restrita: o que devo fazer a seguir?
Numa NVIDIA RTX 5070 Ti, o modelo no nosso teste toma essa decisão em aproximadamente 8 milissegundos.
Toda a inferência corre localmente através da EuLLM. Não há chamada a nenhum fornecedor de modelos externo, nem qualquer API remota envolvida no ciclo de decisão.
A demo inclui também um avaliador determinístico que calcula de forma independente a melhor ação disponível a partir do estado atual.
Ao longo de mais de mil decisões durante uma execução, aproximadamente 95% das escolhas do modelo coincidiram com o melhor movimento identificado pelo avaliador.
Essa distinção é importante. O valor de 95% não é uma "pontuação de precisão" genérica, nem é um LLM-juiz a avaliar outro LLM. Mede a concordância entre a decisão do modelo e uma implementação de referência determinística para esta tarefa específica.
Porquê usar um LLM para decisões?
Uma pergunta natural é por que razão alguém usaria um modelo de linguagem para uma tarefa que pode ser resolvida com código convencional.
Para o Snake em si, não há uma razão convincente. O Snake é simplesmente um ambiente visual onde qualquer pessoa compreende imediatamente se uma decisão foi boa ou má.
As aplicações interessantes começam quando o estado é mais difícil de representar com um conjunto fixo de regras.
Imagine um agente empresarial que recuperou documentos, examinou um pedido de cliente e chamou duas ferramentas. Agora tem de determinar se responde, recupera mais evidências, invoca outra ferramenta ou escala a tarefa para um humano. Isso é um problema de decisão.
Um sistema de segurança pode precisar de decidir se um evento deve ser ignorado, correlacionado com atividade anterior, investigado ou escalado.
Um pipeline RAG pode precisar de decidir se as evidências atualmente recuperadas são suficientes para responder a uma pergunta.
Um sistema industrial pode ter de selecionar a próxima ação a partir de telemetria, condições operacionais e instruções textuais.
O output, em cada caso, pode ser extremamente pequeno mesmo quando o input é complexo. Isso muda a economia da inferência.
Os modelos pequenos nem sempre precisam de se comportar como pequenos chatbots
O setor tende a avaliar modelos pequenos perguntando quão bem conseguem imitar modelos generalistas muito maiores. Isso é útil, mas não é a única forma de os usar.
Um modelo pequeno pode, em vez disso, ser especializado num espaço de decisão restrito. Se o output exigido é uma ação entre cinco possibilidades, gerar vários parágrafos de linguagem natural é uma sobrecarga desnecessária.
Isto é particularmente relevante para a IA local. Um modelo de 2B é suficientemente pequeno para correr em hardware amplamente disponível, sendo ainda assim suficientemente grande para interpretar inputs substancialmente mais ricos do que um classificador tradicional.
A comparação útil, portanto, nem sempre é modelo pequeno versus modelo grande, mas por vezes modelo especializado versus inferência remota de propósito geral para cada decisão.
Para aplicações que tomam centenas ou milhares de decisões, a latência e os requisitos de infraestrutura tornam-se rapidamente significativos.
Onde a EuLLM se encaixa
A EuLLM não é um modelo. É uma plataforma aberta concebida em torno da infraestrutura de IA local e europeia.
O projeto é composto por três partes complementares.
O EuLLM Engine fornece o runtime usado para executar modelos localmente.
O EuLLM Forge foca-se na especialização de modelos, verticalização e fluxos de trabalho teacher-student.
O EuLLM Hub está a ser desenvolvido como um registo europeu de modelos e camada de distribuição, incluindo informação de modelo e de conformidade.
A experiência com o Snake diz respeito sobretudo ao lado do Engine: um pequeno modelo de decisão quantizado a correr localmente e a responder com latência muito baixa.
Mas a combinação a longo prazo é mais interessante. Um modelo teacher maior pode ajudar a produzir modelos especializados mais pequenos através do Forge. Esses modelos podem depois ser executados pelo Engine, próximo das aplicações que os utilizam.
Isso é particularmente atrativo quando a inferência tem de permanecer privada, previsível e económica.
Modelos de decisão e agentes de IA
Uma das aplicações mais óbvias é a IA agêntica.
Os agentes de hoje enviam frequentemente decisões de controlo relativamente simples para grandes modelos remotos:
- O agente deve procurar novamente?
- Que ferramenta deve chamar?
- A evidência atual responde à pergunta do utilizador?
- A tarefa deve ser escalada?
Estas decisões exigem frequentemente compreender o contexto, mas não exigem necessariamente um modelo generativo muito grande.
Um pequeno modelo de decisão local pode potencialmente atuar como parte do plano de controlo, deixando a inferência generativa dispendiosa para as situações em que é realmente necessária.
A mesma arquitetura pode ser aplicada a pipelines RAG. A recuperação não tem de ser uma sequência fixa de pesquisa, reranking e geração. Um modelo pode examinar a qualidade da recuperação e determinar se se justifica outra pesquisa, se deve consultar-se outra fonte ou se a confiança é suficiente para continuar.
Mais uma vez, o output é uma decisão, não um documento.
A execução local muda o orçamento de latência
Uma decisão de 8 ms não é importante apenas porque o número é pequeno. Muda quais aplicações são viáveis.
Se cada passo de um fluxo de trabalho automatizado exige um pedido HTTP remoto a um serviço de inferência externo, a latência acumula-se. A variabilidade da rede e a disponibilidade do serviço passam a fazer parte do ciclo de controlo.
A inferência local elimina essa viagem de ida e volta. Também significa que a informação subjacente não precisa de sair da máquina que executa a aplicação.
Para ambientes empresariais, estas propriedades podem ser tão relevantes quanto a própria qualidade do modelo.
O Snake é a visualização, não o objetivo
Escolhemos o Snake porque o ciclo de decisão é visível. Pode observar-se o modelo a examinar o estado, a escolher uma ação e a ver imediatamente a consequência.
O mesmo mecanismo torna-se visualmente menos empolgante — mas potencialmente muito mais valioso — quando as ações são coisas como:
retrieve_morecall_toolapproveescalateroute_to_departmentinvestigate_eventcontinue_workflow
É aí que os pequenos modelos de decisão se tornam interessantes.
A experiência sugere uma direção mais ampla para a EuLLM: a infraestrutura de IA local não tem de ser concebida apenas em torno da conclusão de chat.
Por vezes, o output mais útil que um LLM pode produzir não é uma frase.
É a próxima ação.
A EuLLM é open source: github.com/eullm/eullm
Projeto: eullm.eu