Die meisten Demonstrationen großer Sprachmodelle folgen demselben Muster: Man gibt dem Modell einen Prompt und wartet, bis es Text generiert.
Aber Textgenerierung ist nur eine von vielen Arten, ein Sprachmodell zu nutzen.
Ein kleines Modell kann auch darauf trainiert oder angepasst werden, einen Zustand zu untersuchen, eine begrenzte Menge möglicher Aktionen zu bewerten und eine davon auszuwählen. In dieser Rolle wirkt das Modell weniger wie ein Chatbot und mehr wie eine Entscheidungs-Engine.
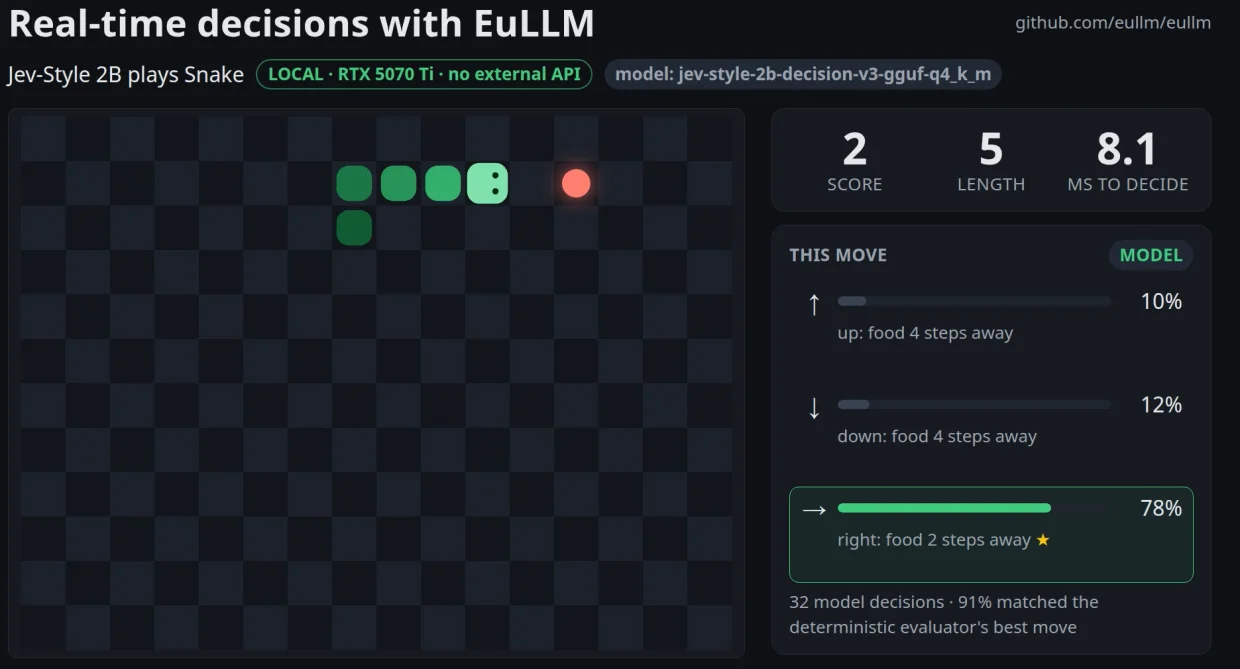
Wir haben eine einfache Demonstration dieser Idee gebaut: ein 2B Jev-Style Decision Model, das lokal mit EuLLM läuft.
Die Aufgabe ist bewusst vertraut: Snake.
Interessant ist nicht das Spiel. Interessant ist, was zwischen zwei Zügen passiert.
Eine Entscheidung in rund 8 Millisekunden
Bei jedem Schritt erhält das Modell den aktuellen Spielzustand und bewertet die verfügbaren Aktionen.
Es muss keinen Aufsatz schreiben oder Hunderte von Tokens produzieren. Es muss eine viel engere Frage beantworten: Was soll ich als Nächstes tun?
Auf einer NVIDIA RTX 5070 Ti trifft das Modell in unserem Test diese Entscheidung in etwa 8 Millisekunden.
Die gesamte Inferenz läuft lokal über EuLLM. Kein Aufruf an einen externen Modellanbieter, keine entfernte API im Entscheidungszyklus.
Die Demo enthält außerdem einen deterministischen Evaluator, der unabhängig die beste verfügbare Aktion aus dem aktuellen Zustand berechnet.
Über mehr als tausend Entscheidungen während eines Durchlaufs hinweg stimmten etwa 95 % der Wahlentscheidungen des Modells mit dem vom Evaluator ermittelten besten Zug überein.
Diese Unterscheidung ist wichtig. Der Wert von 95 % ist kein generischer „Genauigkeits-Score" und kein LLM-Richter, der ein anderes LLM bewertet. Er misst die Übereinstimmung zwischen der Entscheidung des Modells und einer deterministischen Referenzimplementierung für diese spezifische Aufgabe.
Warum ein LLM für Entscheidungen verwenden?
Eine naheliegende Frage ist, warum man überhaupt ein Sprachmodell für eine Aufgabe einsetzen sollte, die mit herkömmlichem Code lösbar ist.
Für Snake selbst gibt es keinen zwingenden Grund. Snake ist schlicht eine visuelle Umgebung, in der jeder sofort erkennt, ob eine Entscheidung gut oder schlecht war.
Die interessanten Anwendungen beginnen dort, wo sich der Zustand schwerer mit einem festen Regelwerk abbilden lässt.
Stellen Sie sich einen Enterprise-Agenten vor, der Dokumente abgerufen, eine Kundenanfrage geprüft und zwei Tools aufgerufen hat. Nun muss er entscheiden, ob er antwortet, weitere Belege einholt, ein weiteres Tool aufruft oder die Aufgabe an einen Menschen eskaliert. Das ist ein Entscheidungsproblem.
Ein Sicherheitssystem muss möglicherweise entscheiden, ob ein Ereignis ignoriert, mit früherer Aktivität korreliert, untersucht oder eskaliert werden soll.
Eine RAG-Pipeline muss möglicherweise entscheiden, ob die aktuell abgerufenen Belege ausreichen, um eine Frage zu beantworten.
Ein industrielles System muss die nächste Aktion möglicherweise aus Telemetrie, Betriebsbedingungen und Textanweisungen auswählen.
Der Output kann in jedem dieser Fälle extrem klein sein, selbst wenn der Input komplex ist. Das verändert die Ökonomie der Inferenz.
Kleine Modelle müssen sich nicht immer wie kleine Chatbots verhalten
Die Branche neigt dazu, kleine Modelle danach zu bewerten, wie nahe sie an viel größere Allzweckmodelle herankommen. Das ist nützlich, aber nicht die einzige Art, sie zu nutzen.
Ein kleines Modell kann stattdessen auf einen engen Entscheidungsraum spezialisiert werden. Wenn der erforderliche Output eine Aktion unter fünf Möglichkeiten ist, ist das Generieren mehrerer Absätze natürlicher Sprache unötiger Overhead.
Das ist besonders relevant für lokale KI. Ein 2B-Modell ist klein genug, um auf weit verbreiteter Hardware zu laufen, aber immer noch groß genug, um deutlich reichhaltigere Eingaben zu interpretieren als ein klassischer Klassifikator.
Der sinnvolle Vergleich lautet daher nicht immer kleines Modell gegen großes Modell, sondern manchmal spezialisiertes Modell gegen entfernte Allzweck-Inferenz für jede einzelne Entscheidung.
Für Anwendungen, die Hunderte oder Tausende von Entscheidungen treffen, werden Latenz und Infrastrukturanforderungen schnell erheblich.
Wo EuLLM ansetzt
EuLLM ist kein Modell. Es ist eine offene Plattform, die um lokale und europäische KI-Infrastruktur herum konzipiert ist.
Das Projekt besteht aus drei sich ergänzenden Teilen.
EuLLM Engine liefert die Laufzeitumgebung zur lokalen Ausführung von Modellen.
EuLLM Forge konzentriert sich auf Modellspezialisierung, Vertikalisierung und Teacher-Student-Workflows.
EuLLM Hub wird als europäisches Modellregister und Verteilungsschicht entwickelt, einschließlich Modell- und Compliance-Informationen.
Das Snake-Experiment betrifft primär die Engine-Seite: ein kleines quantisiertes Decision Model, das lokal läuft und mit sehr geringer Latenz antwortet.
Interessanter ist aber die Kombination auf längere Sicht. Ein größeres Teacher-Modell kann helfen, über Forge spezialisierte kleinere Modelle zu erzeugen. Diese Modelle können dann von Engine nahe an den Anwendungen ausgeführt werden, die sie nutzen.
Das ist besonders attraktiv, wenn Inferenz privat, vorhersehbar und kostengünstig bleiben muss.
Decision Models und KI-Agenten
Eine der offensichtlichsten Anwendungen ist agentische KI.
Heutige Agenten senden häufig relativ einfache Steuerungsentscheidungen an große entfernte Modelle:
- Soll der Agent erneut suchen?
- Welches Tool soll er aufrufen?
- Beantworten die aktuellen Belege die Frage des Nutzers?
- Soll die Aufgabe eskaliert werden?
Diese Entscheidungen erfordern oft Kontextverständnis, benötigen aber nicht zwangsläufig ein sehr großes generatives Modell.
Ein kleines lokales Decision Model kann potenziell Teil der Steuerungsebene sein und teure generative Inferenz den Situationen vorbehalten, in denen sie tatsächlich nötig ist.
Dieselbe Architektur lässt sich auf RAG-Pipelines anwenden. Retrieval muss keine feste Abfolge aus Suche, Reranking und Generierung sein. Ein Modell kann die Qualität des Retrievals prüfen und entscheiden, ob eine weitere Suche gerechtfertigt ist, ob eine weitere Quelle abgefragt werden sollte oder ob die Konfidenz ausreicht, um fortzufahren.
Auch hier ist der Output eine Entscheidung, kein Dokument.
Lokale Ausführung verändert das Latenzbudget
Eine 8-ms-Entscheidung ist nicht deshalb wichtig, weil die Zahl klein ist. Sie verändert, welche Anwendungen praktikabel sind.
Wenn jeder Schritt eines automatisierten Workflows eine entfernte HTTP-Anfrage an einen externen Inferenzdienst erfordert, summiert sich die Latenz. Netzwerkschwankungen und Dienstverfügbarkeit werden Teil der Steuerungsschleife.
Lokale Inferenz entfernt diesen Hin- und Rückweg. Es bedeutet auch, dass die zugrunde liegenden Informationen die Maschine, auf der die Anwendung läuft, nicht verlassen müssen.
Für Unternehmensumgebungen können diese Eigenschaften ebenso relevant sein wie die Modellqualität selbst.
Snake ist die Visualisierung, nicht das Ziel
Wir haben Snake gewählt, weil die Entscheidungsschleife sichtbar ist. Man kann beobachten, wie das Modell den Zustand prüft, eine Aktion wählt und die Konsequenz sofort sichtbar wird.
Derselbe Mechanismus wird visuell weniger spektakulär — aber potenziell viel wertvoller —, wenn die Aktionen Dinge sind wie:
retrieve_morecall_toolapproveescalateroute_to_departmentinvestigate_eventcontinue_workflow
Genau dort werden kleine Decision Models interessant.
Das Experiment deutet auf eine breitere Richtung für EuLLM hin: lokale KI-Infrastruktur muss nicht ausschließlich um Chat-Vervollständigung herum konzipiert sein.
Manchmal ist der nützlichste Output, den ein LLM produzieren kann, kein Satz.
Es ist die nächste Aktion.
EuLLM ist Open Source: github.com/eullm/eullm
Projekt: eullm.eu