La mayoría de las demostraciones de grandes modelos de lenguaje siguen el mismo patrón: se le da un prompt al modelo y se espera a que genere texto.
Pero la generación de texto es solo una forma de usar un modelo de lenguaje.
Un modelo pequeño también puede entrenarse o adaptarse para examinar un estado, evaluar un conjunto limitado de acciones posibles y elegir una de ellas. En ese papel, el modelo empieza a parecerse menos a un chatbot y más a un motor de decisión.
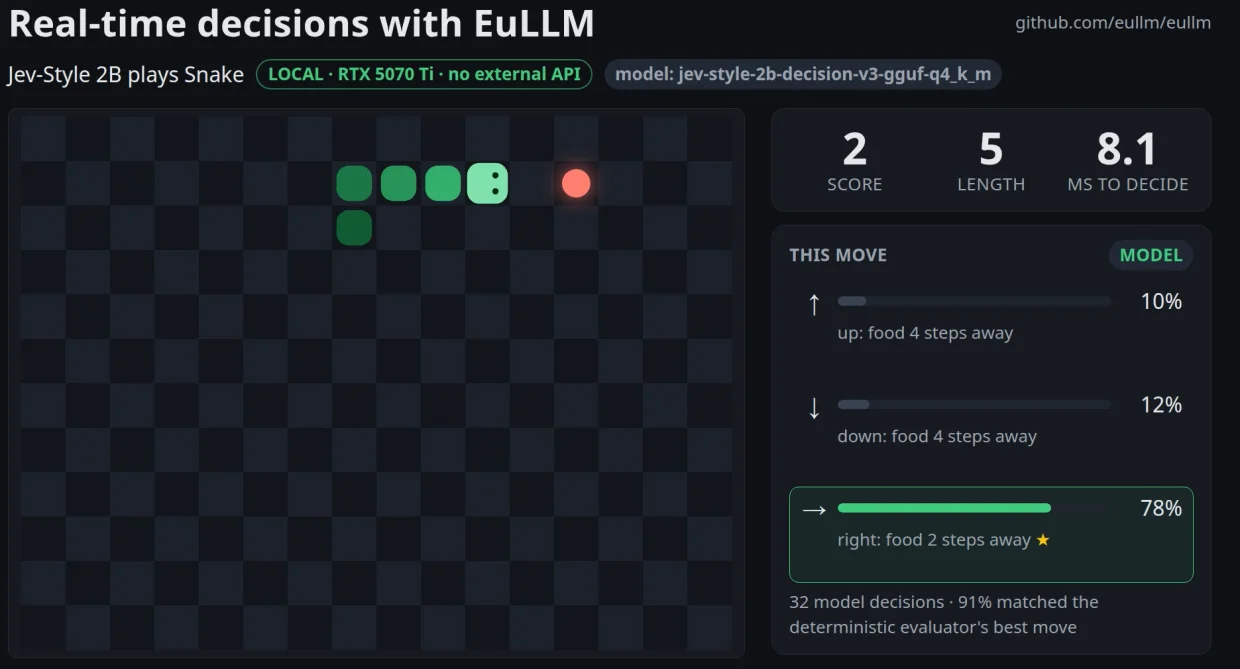
Hemos construido una demostración sencilla de esta idea usando un Decision Model Jev-style de 2B ejecutándose en local con EuLLM.
La tarea es deliberadamente familiar: Snake.
Lo interesante no es el juego. Es lo que ocurre entre dos movimientos.
Una decisión en unos 8 milisegundos
En cada paso, el modelo recibe el estado actual del juego y evalúa las acciones disponibles.
No necesita escribir un ensayo ni producir cientos de tokens. Necesita responder a una pregunta mucho más acotada: ¿qué debo hacer ahora?
En una NVIDIA RTX 5070 Ti, el modelo de nuestra prueba toma esa decisión en aproximadamente 8 milisegundos.
Toda la inferencia se ejecuta en local a través de EuLLM. No hay llamada a ningún proveedor de modelos externo ni ninguna API remota involucrada en el bucle de decisión.
La demo incluye también un evaluador determinista que calcula de forma independiente la mejor acción disponible a partir del estado actual.
A lo largo de más de mil decisiones durante una ejecución, aproximadamente el 95% de las elecciones del modelo coincidió con el mejor movimiento identificado por el evaluador.
Esa distinción importa. La cifra del 95% no es una "puntuación de precisión" genérica, y no es un LLM-juez evaluando a otro LLM. Mide la concordancia entre la decisión del modelo y una implementación de referencia determinista para esta tarea específica.
¿Por qué usar un LLM para tomar decisiones?
Una pregunta natural es por qué alguien usaría un modelo de lenguaje para una tarea que puede resolverse con código convencional.
Para Snake en sí, no hay una razón de peso. Snake es simplemente un entorno visual donde cualquiera puede entender de inmediato si una decisión fue buena o mala.
Las aplicaciones interesantes empiezan cuando el estado es más difícil de representar con un conjunto de reglas fijo.
Imagine un agente empresarial que ha recuperado documentos, examinado una solicitud de un cliente y llamado a dos herramientas. Ahora tiene que determinar si responde, recupera más evidencia, invoca otra herramienta o escala la tarea a un humano. Eso es un problema de decisión.
Un sistema de seguridad podría tener que decidir si un evento debe ignorarse, correlacionarse con actividad previa, investigarse o escalarse.
Un pipeline RAG puede tener que decidir si la evidencia recuperada actualmente es suficiente para responder a una pregunta.
Un sistema industrial puede tener que seleccionar la siguiente acción a partir de telemetría, condiciones de operación e instrucciones textuales.
En cada caso, la salida puede ser extremadamente pequeña incluso cuando la entrada es compleja. Eso cambia la economía de la inferencia.
Los modelos pequeños no siempre necesitan comportarse como pequeños chatbots
El sector tiende a evaluar los modelos pequeños preguntándose cuán fielmente pueden imitar a modelos generalistas mucho más grandes. Eso es útil, pero no es la única forma de usarlos.
Un modelo pequeño puede especializarse en cambio en un espacio de decisión reducido. Si la salida requerida es una acción entre cinco posibilidades, generar varios párrafos de lenguaje natural es una sobrecarga innecesaria.
Esto es especialmente relevante para la IA local. Un modelo de 2B es lo bastante pequeño para ejecutarse en hardware ampliamente disponible, y a la vez lo bastante grande para interpretar entradas sustancialmente más ricas que un clasificador tradicional.
Por tanto, la comparación útil no siempre es modelo pequeño frente a modelo grande, sino a veces modelo especializado frente a inferencia general remota para cada decisión.
Para aplicaciones que toman cientos o miles de decisiones, la latencia y los requisitos de infraestructura se vuelven rápidamente significativos.
Dónde encaja EuLLM
EuLLM no es un modelo. Es una plataforma abierta diseñada en torno a la infraestructura de IA local y europea.
El proyecto se compone de tres partes complementarias.
EuLLM Engine proporciona el runtime usado para ejecutar modelos en local.
EuLLM Forge se centra en la especialización de modelos, la verticalización y los flujos de trabajo teacher-student.
EuLLM Hub se está desarrollando como un registro europeo de modelos y capa de distribución, incluyendo información de modelo y de cumplimiento normativo.
El experimento de Snake concierne principalmente al lado de Engine: un pequeño modelo de decisión cuantizado ejecutándose en local y respondiendo con una latencia muy baja.
Pero la combinación a más largo plazo es más interesante. Un modelo teacher más grande puede ayudar a producir modelos especializados más pequeños a través de Forge. Esos modelos pueden luego ser ejecutados por Engine cerca de las aplicaciones que los usan.
Eso resulta especialmente atractivo cuando la inferencia debe permanecer privada, predecible y económica.
Modelos de decisión y agentes de IA
Una de las aplicaciones más obvias es la IA agéntica.
Los agentes actuales envían con frecuencia decisiones de control relativamente simples a grandes modelos remotos:
- ¿Debe el agente buscar de nuevo?
- ¿Qué herramienta debe llamar?
- ¿La evidencia actual responde a la pregunta del usuario?
- ¿Debe escalarse la tarea?
Estas decisiones a menudo requieren comprender el contexto, pero no necesariamente requieren un modelo generativo muy grande.
Un pequeño modelo de decisión local puede potencialmente actuar como parte del plano de control, dejando la inferencia generativa costosa para las situaciones en las que realmente es necesaria.
La misma arquitectura puede aplicarse a los pipelines RAG. La recuperación no tiene por qué ser una secuencia fija de búsqueda, reranking y generación. Un modelo puede examinar la calidad de la recuperación y determinar si está justificada otra búsqueda, si debe consultarse otra fuente o si la confianza es suficiente para continuar.
De nuevo, la salida es una decisión, no un documento.
La ejecución local cambia el presupuesto de latencia
Una decisión de 8 ms no es importante simplemente porque el número sea pequeño. Cambia qué aplicaciones resultan prácticas.
Si cada paso de un flujo de trabajo automatizado requiere una solicitud HTTP remota a un servicio de inferencia externo, la latencia se acumula. La variabilidad de la red y la disponibilidad del servicio pasan a formar parte del bucle de control.
La inferencia local elimina ese ida y vuelta. También significa que la información subyacente no necesita salir de la máquina que ejecuta la aplicación.
Para entornos empresariales, esas propiedades pueden ser tan relevantes como la calidad del modelo en sí.
Snake es la visualización, no el objetivo
Elegimos Snake porque el bucle de decisión es visible. Se puede observar al modelo examinar el estado, elegir una acción y ver de inmediato la consecuencia.
El mismo mecanismo resulta visualmente menos vistoso —pero potencialmente mucho más valioso— cuando las acciones son cosas como:
retrieve_morecall_toolapproveescalateroute_to_departmentinvestigate_eventcontinue_workflow
Ahí es donde los pequeños modelos de decisión se vuelven interesantes.
El experimento sugiere una dirección más amplia para EuLLM: la infraestructura de IA local no tiene por qué diseñarse únicamente en torno a la completación de chat.
A veces, la salida más útil que puede producir un LLM no es una frase.
Es la siguiente acción.
EuLLM es de código abierto: github.com/eullm/eullm
Proyecto: eullm.eu