La plupart des démonstrations de grands modèles de langage suivent le même schéma : on donne un prompt au modèle et on attend qu'il génère du texte.
Mais la génération de texte n'est qu'une façon parmi d'autres d'utiliser un modèle de langage.
Un petit modèle peut aussi être entraîné ou adapté pour examiner un état, évaluer un ensemble limité d'actions possibles et en choisir une. Dans ce rôle, le modèle ressemble de moins en moins à un chatbot et de plus en plus à un moteur de décision.
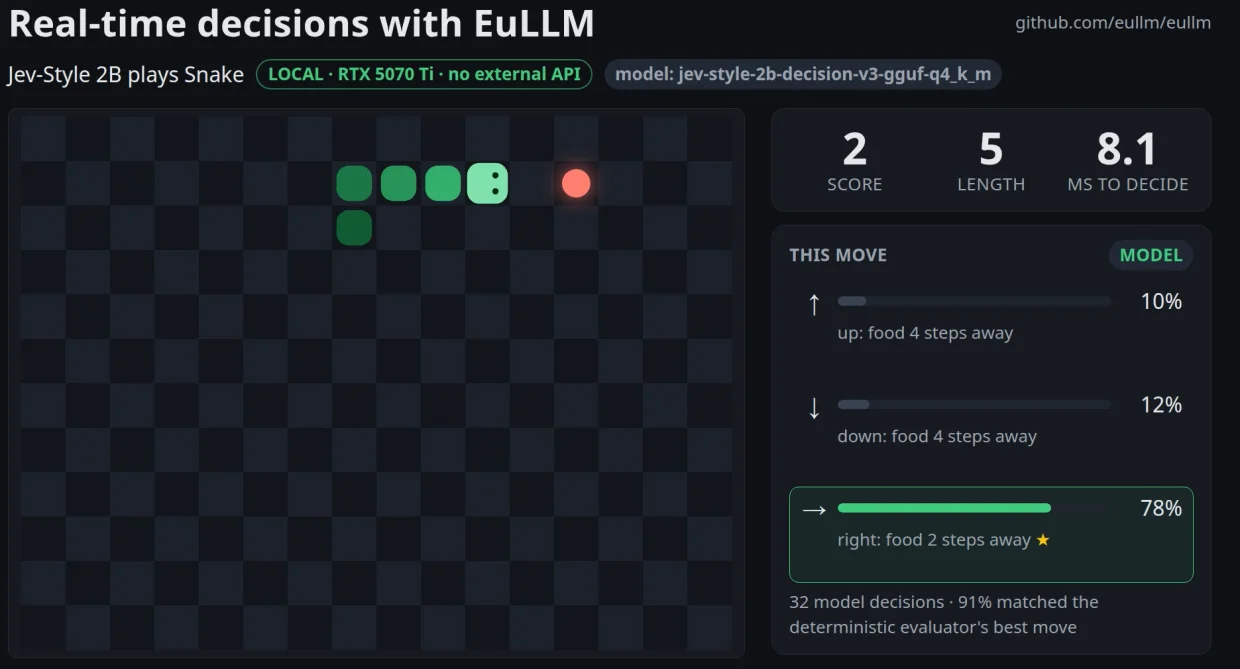
Nous avons construit une démonstration simple de cette idée avec un Decision Model Jev-style de 2B tournant en local avec EuLLM.
La tâche est délibérément familière : Snake.
Ce qui est intéressant, ce n'est pas le jeu. C'est ce qui se passe entre deux coups.
Une décision en environ 8 millisecondes
À chaque étape, le modèle reçoit l'état actuel du jeu et évalue les actions disponibles.
Il n'a pas besoin d'écrire un essai ni de produire des centaines de tokens. Il doit répondre à une question bien plus étroite : que dois-je faire maintenant ?
Sur une NVIDIA RTX 5070 Ti, le modèle de notre test prend cette décision en environ 8 millisecondes.
L'inférence tourne entièrement en local via EuLLM. Aucun appel à un fournisseur de modèle externe, aucune API distante impliquée dans la boucle de décision.
La démo inclut aussi un évaluateur déterministe qui calcule indépendamment la meilleure action disponible à partir de l'état courant.
Sur plus d'un millier de décisions au cours d'une exécution, environ 95 % des choix du modèle correspondaient au meilleur coup identifié par l'évaluateur.
Cette distinction compte. Le chiffre de 95 % n'est pas un « score de précision » générique, et ce n'est pas un LLM-juge évaluant un autre LLM. Il mesure l'accord entre la décision du modèle et une implémentation de référence déterministe pour cette tâche spécifique.
Pourquoi utiliser un LLM pour prendre des décisions ?
Une question naturelle est de savoir pourquoi on utiliserait un modèle de langage pour une tâche qui peut être résolue avec du code conventionnel.
Pour Snake en soi, il n'y a pas de raison convaincante. Snake est simplement un environnement visuel où chacun peut immédiatement comprendre si une décision était bonne ou mauvaise.
Les applications intéressantes commencent lorsque l'état est plus difficile à représenter avec un ensemble de règles fixe.
Imaginez un agent d'entreprise qui a récupéré des documents, examiné une demande client et appelé deux outils. Il doit maintenant déterminer s'il répond, récupère davantage de preuves, invoque un autre outil ou escalade la tâche vers un humain. C'est un problème de décision.
Un système de sécurité pourrait avoir à décider si un événement doit être ignoré, corrélé avec l'activité précédente, investigué ou escaladé.
Un pipeline RAG peut avoir à décider si les preuves actuellement récupérées suffisent à répondre à une question.
Un système industriel peut devoir sélectionner l'action suivante à partir de la télémétrie, des conditions d'exploitation et d'instructions textuelles.
Dans chaque cas, la sortie peut être extrêmement petite même lorsque l'entrée est complexe. Cela change l'économie de l'inférence.
Les petits modèles n'ont pas toujours besoin de se comporter comme de petits chatbots
Le secteur a tendance à évaluer les petits modèles en se demandant à quel point ils imitent des modèles généralistes bien plus grands. C'est utile, mais ce n'est pas la seule façon de les utiliser.
Un petit modèle peut au contraire être spécialisé sur un espace de décision restreint. Si la sortie requise est une action parmi cinq possibilités, générer plusieurs paragraphes de langage naturel est une surcharge inutile.
C'est particulièrement pertinent pour l'IA locale. Un modèle de 2B est assez petit pour tourner sur du matériel largement disponible, tout en restant assez grand pour interpréter des entrées nettement plus riches qu'un classificateur traditionnel.
La comparaison utile n'est donc pas toujours petit modèle contre grand modèle, mais parfois modèle spécialisé contre inférence générique distante pour chaque décision.
Pour les applications prenant des centaines ou des milliers de décisions, la latence et les exigences d'infrastructure deviennent rapidement significatives.
Où EuLLM s'inscrit
EuLLM n'est pas un modèle. C'est une plateforme ouverte conçue autour de l'infrastructure IA locale et européenne.
Le projet se compose de trois parties complémentaires.
EuLLM Engine fournit le runtime utilisé pour exécuter les modèles en local.
EuLLM Forge se concentre sur la spécialisation des modèles, la verticalisation et les workflows teacher-student.
EuLLM Hub est en développement en tant que registre de modèles européen et couche de distribution, incluant les informations sur les modèles et leur conformité.
L'expérience Snake concerne principalement le volet Engine : un petit modèle de décision quantifié tournant en local et répondant avec une latence très faible.
Mais la combinaison à plus long terme est plus intéressante. Un modèle teacher plus grand peut aider à produire des modèles spécialisés plus petits via Forge. Ces modèles peuvent ensuite être exécutés par Engine, au plus près des applications qui les utilisent.
C'est particulièrement attractif lorsque l'inférence doit rester privée, prévisible et peu coûteuse.
Modèles de décision et agents IA
L'une des applications les plus évidentes est l'IA agentique.
Les agents d'aujourd'hui envoient fréquemment des décisions de contrôle relativement simples à de grands modèles distants :
- L'agent doit-il chercher à nouveau ?
- Quel outil doit-il appeler ?
- Les preuves actuelles répondent-elles à la question de l'utilisateur ?
- La tâche doit-elle être escaladée ?
Ces décisions nécessitent souvent de comprendre le contexte, mais elles ne nécessitent pas forcément un très grand modèle génératif.
Un petit modèle de décision local peut potentiellement faire partie du plan de contrôle, laissant l'inférence générative coûteuse aux situations où elle est réellement nécessaire.
La même architecture peut être appliquée aux pipelines RAG. La récupération n'a pas besoin d'être une séquence fixe de recherche, reranking et génération. Un modèle peut examiner la qualité de la récupération et déterminer si une nouvelle recherche est justifiée, si une autre source doit être interrogée, ou si la confiance est suffisante pour continuer.
Là encore, la sortie est une décision, pas un document.
L'exécution locale change le budget de latence
Une décision en 8 ms n'est pas importante simplement parce que le chiffre est petit. Elle change les applications qui deviennent praticables.
Si chaque étape d'un workflow automatisé nécessite une requête HTTP distante vers un service d'inférence externe, la latence s'accumule. La variabilité du réseau et la disponibilité du service font alors partie de la boucle de contrôle.
L'inférence locale supprime cet aller-retour. Cela signifie aussi que l'information sous-jacente n'a pas besoin de quitter la machine qui exécute l'application.
Pour les environnements d'entreprise, ces propriétés peuvent être aussi pertinentes que la qualité du modèle elle-même.
Snake est la visualisation, pas l'objectif
Nous avons choisi Snake parce que la boucle de décision est visible. Vous pouvez observer le modèle examiner l'état, choisir une action, et en voir immédiatement la conséquence.
Le même mécanisme devient visuellement moins spectaculaire — mais potentiellement bien plus précieux — lorsque les actions sont des choses comme :
retrieve_morecall_toolapproveescalateroute_to_departmentinvestigate_eventcontinue_workflow
C'est là que les petits modèles de décision deviennent intéressants.
L'expérience suggère une orientation plus large pour EuLLM : l'infrastructure IA locale n'a pas à être conçue uniquement autour de la complétion de chat.
Parfois, la sortie la plus utile qu'un LLM puisse produire n'est pas une phrase.
C'est l'action suivante.
EuLLM est open source : github.com/eullm/eullm
Projet : eullm.eu