Dwa tygodnie temu zalogowaliśmy się do dwóch terminali, które wyglądały bardzo inaczej niż nasze zwykłe maszyny deweloperskie. Jeden przywitał nas banerem ASCII „LEONARDO” i kolejką SLURM. Drugi, „LUMI” wyrenderowany w pikselowych blokach, opisywał siebie jako „The Supercomputer of the North”.
Oba są systemami EuroHPC Joint Undertaking. Oba należą do najpotężniejszych komputerów na kontynencie. I oba są teraz częścią tego, jak budujemy EULLM.
Co otrzymaliśmy
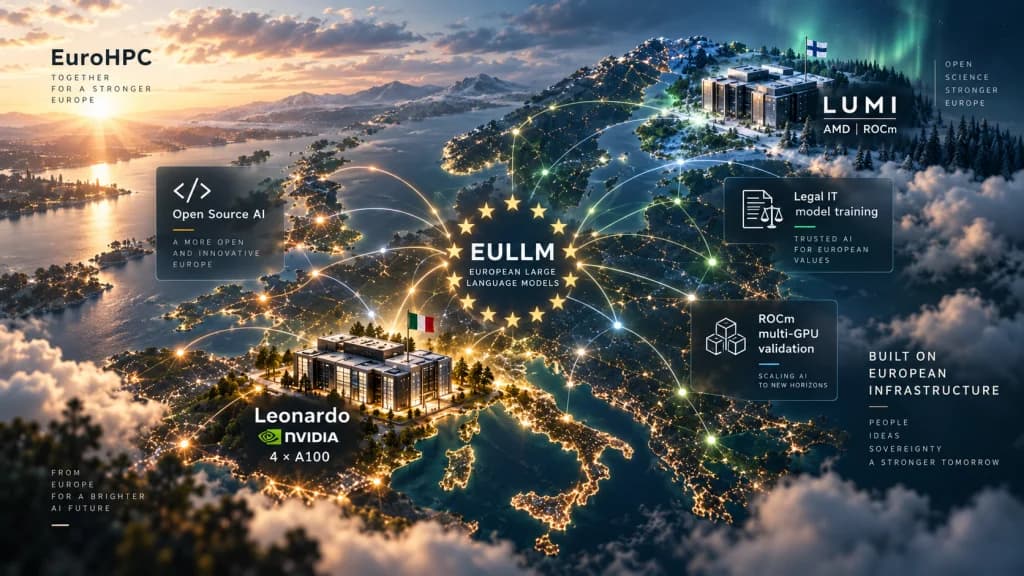
Leonardo mieści się w Cineca w Bolonii we Włoszech. Moduł booster, do którego mamy dostęp, obejmuje 3456 węzłów obliczeniowych, każdy z 32 rdzeniami Ice Lake na poziomie 2,60 GHz, 512 GB RAM i czterema GPU NVIDIA Ampere A100 z 64 GB VRAM. Połączenie to 200G HDR Infiniband Dragonfly+. Krótko mówiąc: poważna maszyna.
LUMI mieści się w CSC w Kajaani w Finlandii. Nazywa siebie „The Supercomputer of the North” — i liczby na to zasługują. Dla nas kluczowe: partycja GPU LUMI jest zbudowana w całości na sprzęcie AMD — co oznacza ROCm, nie CUDA.
Co robimy na Leonardo
Główna praca na Leonardo to nasz pierwszy model wertykalny: Legal IT.
Celem jest specjalista 7B wytrenowany na wyselekcjonowanym włoskim orzecznictwie, kodeksie cywilnym i corpus regulacyjnym UE — model rozumiejący umowy, oceny RODO i pytania dotyczące zgodności z UE w sposób, w jaki ogólny model 70B nie potrafi. Nie dlatego, że jest większy, ale dlatego, że każdy parametr jest trafny.
Pipeline: model frontier open-weight 70B jako nauczyciel, structural pruning do usunięcia pojemności nieistotnej dla rozumowania prawnego, knowledge distillation do studenta 7B, kwantyzacja dla efektywności wnioskowania i identity fine-tuning dla persony i instrukcji. Pipeline Forge, krótko mówiąc, uruchomiony na prawdziwym żelazie.
Zanim przystąpiliśmy do treningu, chcieliśmy zweryfikować, że EULLM Engine może faktycznie obsługiwać sprzęt. Uruchomiliśmy więc model 27B na wszystkich czterech A100 jednego węzła. Zadziałało. Ścieżka wnioskowania multi-GPU — oparta na CUDA, z własnym batchingiem i zarządzaniem pamięcią EULLM — poradziła sobie z GGUF 27B bez problemów, z oczekiwanymi zyskami przepustowości wynikającymi z rozłożenia wag modelu na cztery karty 64 GB.
To znaczący punkt danych. Mówi nam, że gdy Legal IT 7B będzie dostępny, europejska organizacja z jednym węzłem 4×A100 (on-premise lub w chmurze) będzie mogła go uruchomić komfortowo — z marginesem do obsługi równoczesnych użytkowników.
Co robimy na LUMI
LUMI to inne wyzwanie. Partycja GPU LUMI używa akceleratorów AMD Instinct, co oznacza, że odpowiednim stosem jest ROCm, a nie CUDA.
To ważniejsze niż mogłoby się wydawać. „Działa na GPU” to nie monolit. Kod działający doskonale na kartach NVIDIA może nie kompilować się, może ulegać awariom lub działać ze słabą wydajnością na sprzęcie AMD. EULLM Engine już obsługuje ROCm — oznaczyłyśmy to jako eksperymentalne w notach wydania — ale eksperymentalne to nie to samo co zwalidowane.
LUMI to miejsce, gdzie to właściwie walidujemy. Celem jest uruchomienie stosu wnioskowania EULLM na wielu GPU AMD i potwierdzenie, że przepustowość, poprawność i stabilność utrzymują się pod realnym obciążeniem. Używamy tych samych wag modeli, tej samej powierzchni API, na radykalnie innym krzemie.
Dlaczego to ma znaczenie dla europejskiej suwerenności AI? Ponieważ lock-in sprzętowy to forma zależności. Jeśli EULLM działa niezawodnie tylko na NVIDIA, europejskie organizacje korzystające z infrastruktury AMD — a w europejskich sieciach HPC i badawczych istnieją znaczące wdrożenia AMD — są wykluczone. LUMI daje nam prawdziwe środowisko AMD multi-GPU zamiast symulatora lub maszyny testowej z jedną kartą.
Dlaczego EuroHPC
Mogliśmy wynająć czas GPU od amerykańskiego hiperskalera. Nie zrobiliśmy tego.
Systemy EuroHPC to europejska infrastruktura publiczna. Dane, na których obliczamy, pozostają w europejskiej jurysdykcji. Proces alokacji jest konkurencyjny i oparty na zasługach — składa się opis projektu, wyjaśnia co się buduje i dlaczego potrzebuje mocy obliczeniowej, a komisja decyduje. Uważamy, że jest coś słusznego w budowaniu europejskiego suwerennego stosu AI na europejskich suwerennych obliczeniach.
Jest też praktyczny argument: sprzęt w Leonardo i LUMI jest naprawdę doskonały. Cztery karty A100 64 GB na węzeł to coś, czego nie można łatwo odtworzyć na instancjach spot. Skala GPU AMD w LUMI jest po prostu niedostępna do wynajmu nigdzie indziej w Europie.
Co jest dalej
Legal IT to pipeline w toku. Kuracja zbioru danych jest prawie zakończona. Sesje pruning i distillation odbędą się w ciągu najbliższych tygodni na Leonardo. Gdy model 7B przejdzie nasze wewnętrzne progi jakości — i karta zgodności AI Act zostanie opracowana — trafi do Huba.
Dla LUMI: trwają sesje walidacji multi-GPU ROCm. Opublikujemy notę techniczną z benchmarkami, gdy wyniki będą wystarczająco solidne, by za nimi stać.
Jeśli budujecie na europejskiej infrastrukturze i chcecie wiedzieć, kiedy Legal IT będzie dostępny, najlepszym miejscem do śledzenia jest nasz GitHub. Issues, dyskusje i noty wydania odbywają się tam publicznie.
Budujemy to otwarcie, na europejskich maszynach, dla europejskich przypadków użycia. To cały sens.