Uruchamiaj AI tam, gdzie znajdują się Państwa dane.
EuLLM Engine to open-source'owe środowisko uruchomieniowe dla dużych modeli językowych. Jeden plik binarny w Rust, kompatybilny z OpenAI i Ollama, zero telemetrii. Od Raspberry Pi po NVIDIA GH200 lub AMD Instinct MI250X.
Twoje modele, Twoja infrastruktura, Twoje dane.
$ curl -fsSL https://raw.githubusercontent.com/eullm/eullm/main/installer/install.sh | sh
$ eullm run hf.co/Qwen/Qwen3-8B-GGUF:Q4_K_M
Jeden runtime. Jedna platforma, na której można budować.
Engine uruchamia modele wszędzie. Forge i Hub tworzą i dystrybuują te, które Państwo specjalizują.
Engine
Open-source'owy runtime dla dużych modeli językowych. Jeden plik binarny, kompatybilny z OpenAI i Ollama, zero telemetrii.
Przeczytaj dokumentację Engine →Forge — specjalizacja
Dostrajaj, destyluj i oceniaj otwarte modele na własnych danych. Małe modele specjalistyczne, które odpowiadają precyzyjnie na podstawie Państwa dokumentów i źródeł, eksportowane jako GGUF, który Państwo posiadają i uruchamiają na Engine.
Poznaj PlatformHub — dystrybucja
Publikuj, wersjonuj i odkrywaj modele, każdy z kartą modelu i kartą zgodności. Możliwość self-hostingu, z regionem hostowanym w UE.
Poznaj PlatformOpen source, zbudowane w Europie
EuLLM jest open source (AGPL-3.0) i zostało zbudowane w Mediolanie przez I3K Technologies. Trenujemy i testujemy wydajność na superkomputerach EuroHPC Leonardo, LUMI i JUPITER. Zbudowane w Europie, do uruchomienia wszędzie tam, gdzie Państwo zechcą.
Suwerenność danych →
Od otwartego modelu do specjalisty, aż po produkcję
Wyspecjalizuj
Forge dostraja i destyluje model open-weight na Państwa własnych danych.
Oceń
Testy held-out mierzą dokładność, zanim cokolwiek zostanie opublikowane.
Opublikuj
Hub wersjonuje go z kartą modelu i kartą zgodności.
Uruchom
Engine uruchamia go wszędzie — na laptopie, serwerze lub urządzeniu brzegowym.
Dlaczego EuLLM Engine
- ~10 ms
- na decyzję
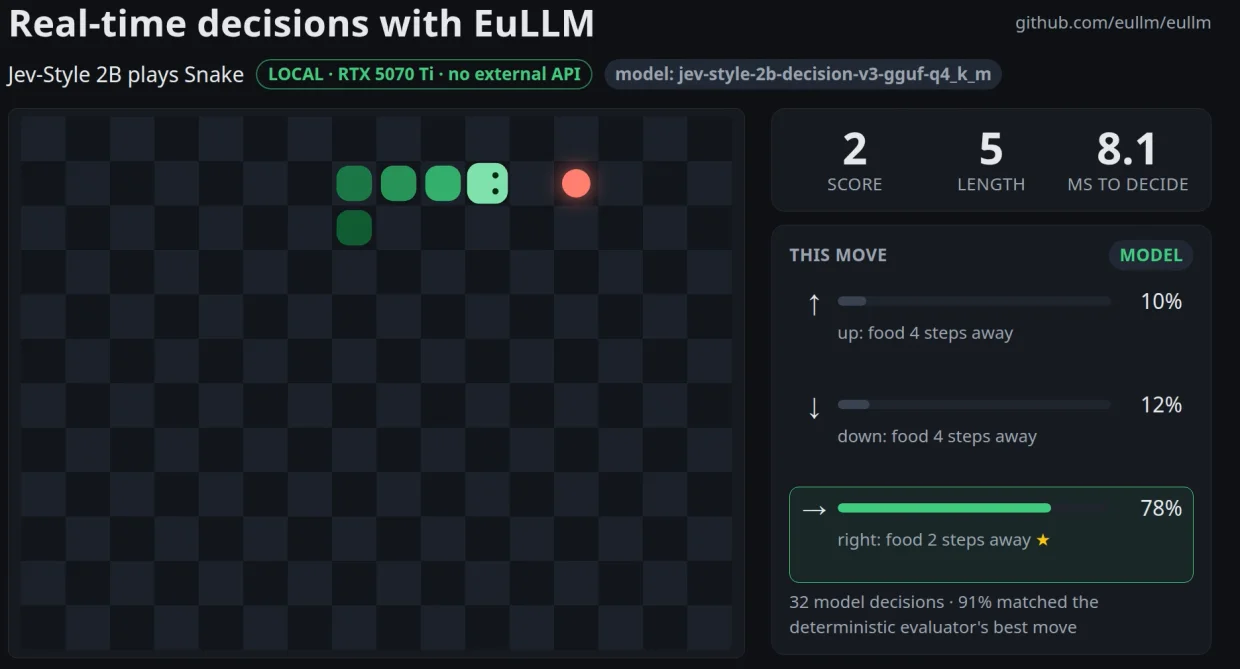
- Model 2B podejmujący każdy ruch w Snake na RTX 5070 Ti
- 1,065 tok/s
- przy 16 równoczesnych użytkownikach
- na jednym RTX 5070 Ti, 8.1× jednego żądania
- 10.8 tok/s
- 35B MoE, tylko CPU
- na płytce ARM 20 W (Radxa Orion O6)
- CUDA · ROCm · Vulkan · Metal · CPU
- Działa wszędzie
- jeden silnik, każdy backend
Prywatność domyślnie
Prompty, dokumenty i odpowiedzi nigdy nie opuszczają Państwa maszyny. Brak telemetrii, brak zewnętrznego API.
Bezpośredni zamiennik
API Ollama i OpenAI na porcie 11434. Open WebUI, LangChain, n8n i dowolny klient OpenAI działają bez zmian.
Szybki tam, gdzie to ważne
Ciągłe wsadowanie, kwantyzowana pamięć podręczna KV dla długich kontekstów, duże modele MoE na małych GPU.
Decyzje, nie tylko tekst
/v1/systemone odczytuje prawdopodobieństwo każdej opcji bezpośrednio z modelu: ustrukturyzowane decyzje w milisekundach, do routingu, triage'u i agentów.
Działa wszędzie
Laptop, stacja robocza, serwer on-premise, urządzenie brzegowe, prywatna chmura. Jeden plik binarny, bez Pythona, bez wymaganego Dockera.
Wbudowany ślad audytowy
Każde żądanie jest rejestrowane lokalnie w pliku, który Państwo kontrolują, gotowe dla Państwa audytorów.
Interfejs czatu jest wbudowany, dostępny pod localhost:11435.
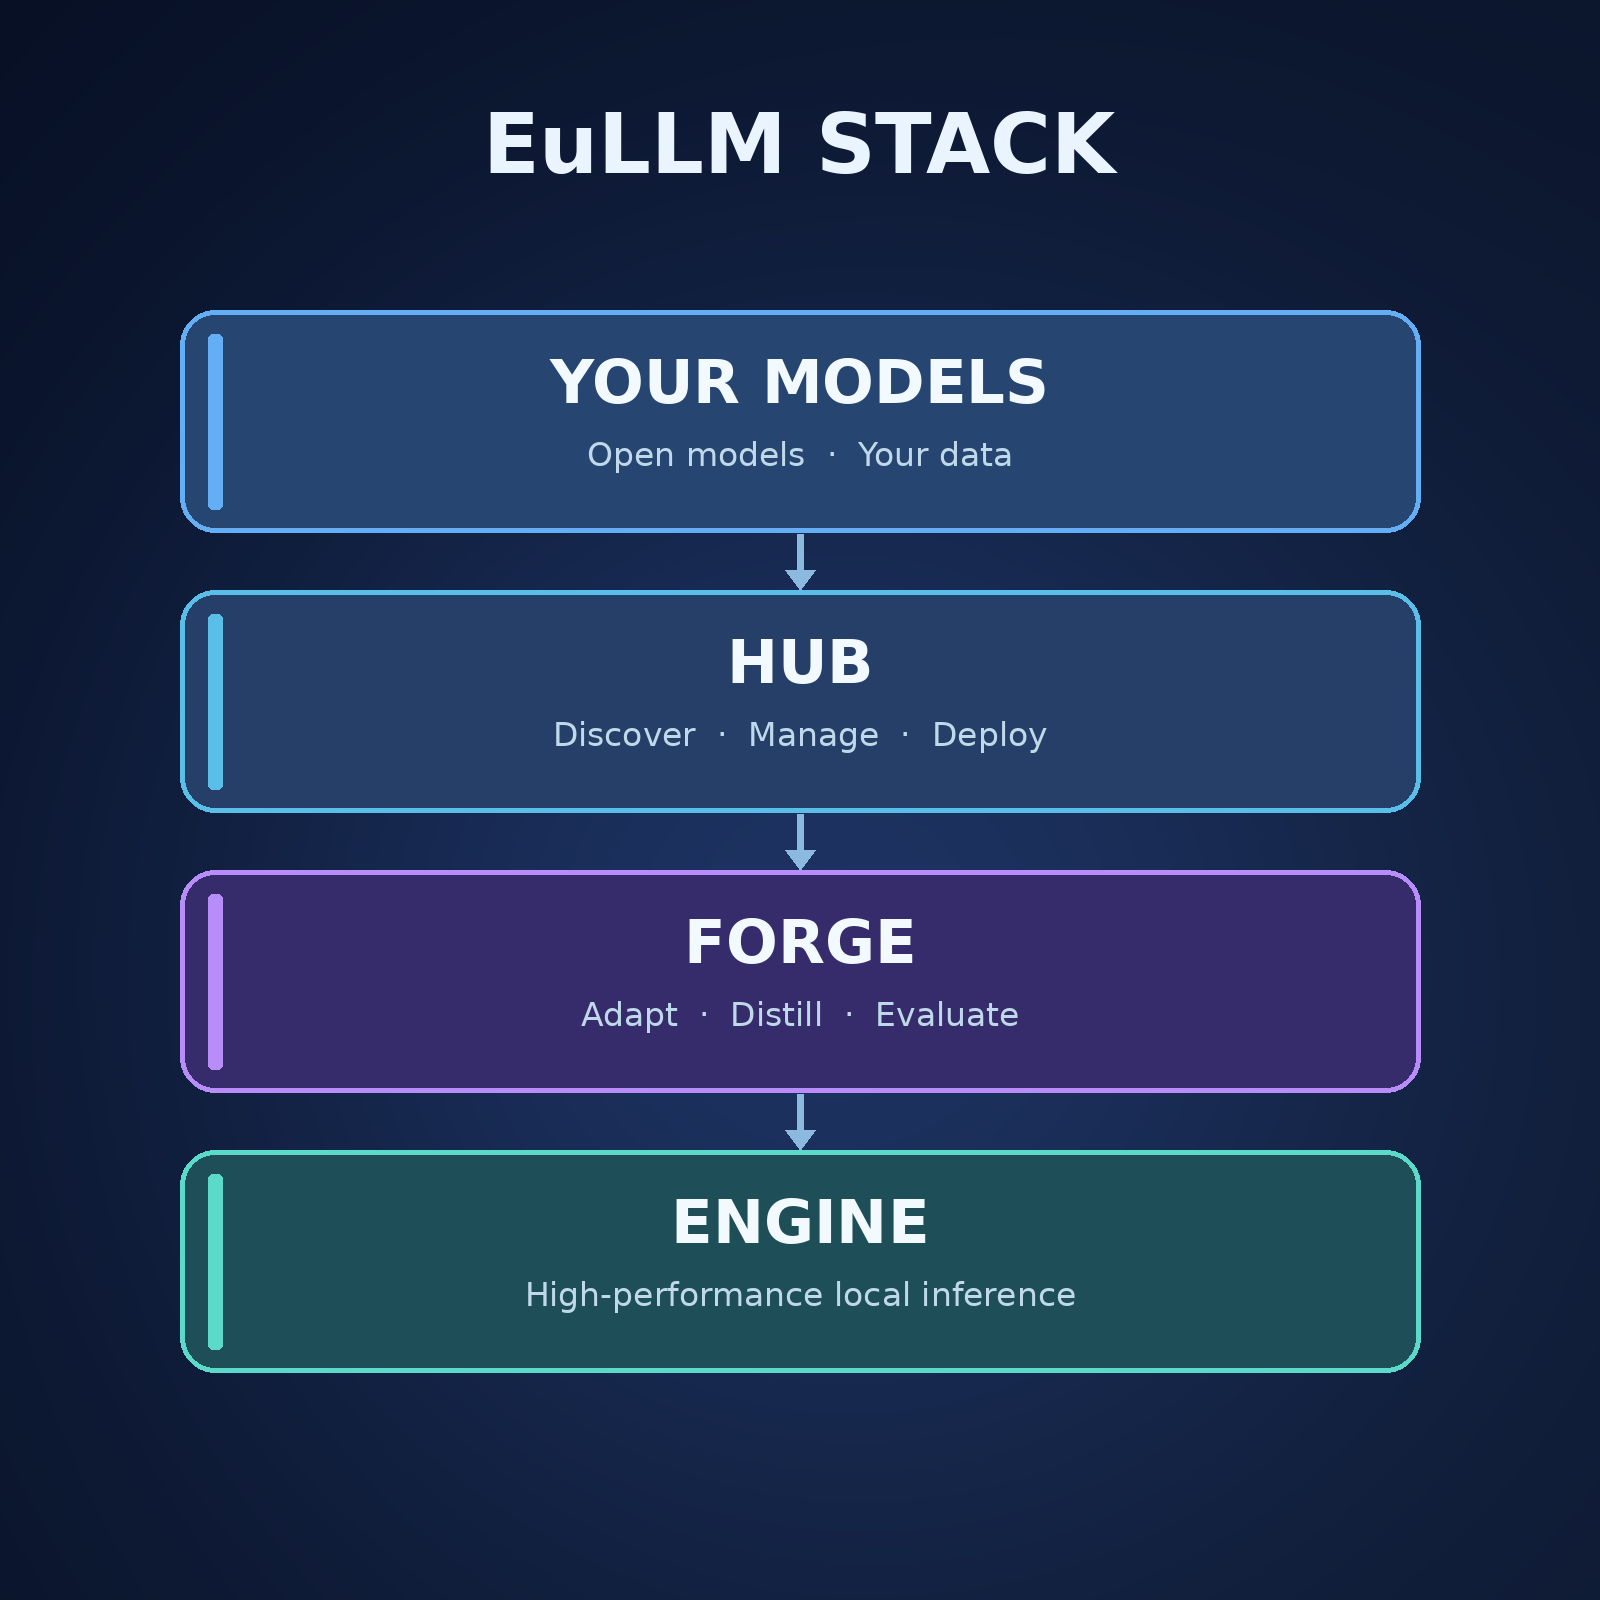
Jeden stos, trzy warstwy
Modele specjalistyczne, które Państwo posiadają, zbudowane na otwartej platformie, obsługiwane przez runtime działający wszędzie.
Państwa modele
Wyspecjalizowane, ocenione i gotowe do uruchomienia — pliki GGUF, które są całkowicie Państwa własnością.
Hub — dystrybucja
PrototypPublikuj, wersjonuj i odkrywaj modele, każdy z kartą modelu i kartą zgodności. Możliwość self-hostingu, z regionem hostowanym w UE.
Forge — specjalizacja
W trakcie tworzeniaDostrajaj, destyluj i oceniaj otwarte modele na własnych danych. Małe modele specjalistyczne, które odpowiadają precyzyjnie na podstawie Państwa dokumentów i źródeł, eksportowane jako GGUF, który Państwo posiadają i uruchamiają na Engine.
Engine
Uruchamia dowolny model GGUF, na dowolnym sprzęcie, z zerową telemetrią.
Opublikowano: legal-it-4b i legal-it-8b dla włoskiego prawa, ocenione na 429 pytaniach testowych spoza zbioru treningowego.
Open source. Uruchamiany przez Państwa. Ulepszany przez wszystkich.
Otwarty, wszędzie tam, gdzie już Państwo pracują
EuLLM integruje się z narzędziami i infrastrukturą, których Państwo już używają.

GitHub
Open source, AGPL-3.0. Każda linia możliwa do zweryfikowania.
Hugging Face
Opublikowane modele specjalistyczne, gotowe do pobrania.
I3K RAG Engine
System wyszukiwania zbudowany dla modeli specjalistycznych EuLLM.
EuroHPC
Trenowany i testowany na Leonardo, LUMI i JUPITER.
Zbudowane dla pracy regulowanej
Sektor prawny, ochrona zdrowia, finanse i administracja publiczna nie mogą przekazywać swoich danych do cudzego API. EuLLM działa w całości na infrastrukturze, którą Państwo kontrolują, rejestruje każde żądanie lokalnie i dostarcza karty modelu oraz karty zgodności z każdym modelem Platform.
- Lokalny ślad audytowy dla każdego wnioskowania
- Wsparcie dokumentacyjne dla EU AI Act i GDPR
- Modele specjalistyczne dla pracy prawnej, medycznej i finansowej (najpierw prawo)
- Region Hub hostowany w UE dla organizacji, które go wymagają
Żaden plik binarny ani karta zgodności same w sobie nie sprawiają, że system jest zgodny z przepisami: zgodność jest cechą całego systemu i sposobu zarządzania nim.
Najnowsze artykuły
29 września 2026 · 6 min read
Od tokenów do decyzji: uruchamiamy lokalnie 2B Jev-style Decision Model z EuLLM
2B Jev-style Decision Model działający lokalnie z EuLLM podejmuje decyzje w czasie rzeczywistym w około 10 ms na RTX 5070 Ti, bez żadnego zewnętrznego API.
Czytaj więcej →
12 września 2026 · 4 min read
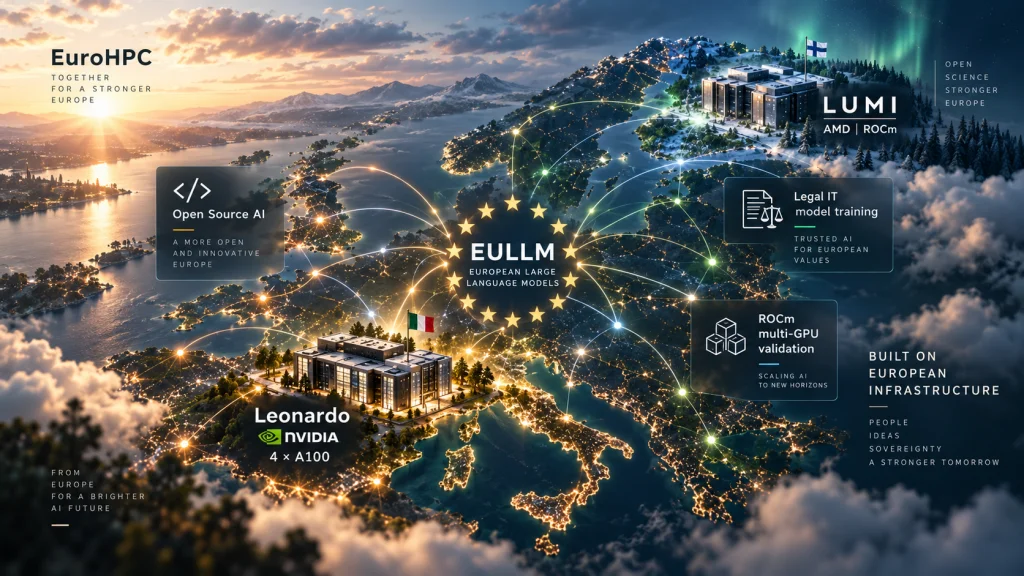
Dostaliśmy czas na Leonardo i LUMI. Oto co budujemy.
EULLM otrzymał czas obliczeniowy na dwóch superkomputerach EuroHPC: Leonardo w Bolonii i LUMI w Finlandii. Budujemy nasz pierwszy model wertykalny na A100 i walidujemy ROCm multi-GPU na największym klastrze AMD na kontynencie.
Czytaj więcej →
Twoje modele, Twoja infrastruktura, Twoje dane.
Zainstaluj EuLLM Engine za pomocą jednej komendy albo porozmawiaj z nami o modelu specjalistycznym dla swojej dziedziny.