Większość demonstracji dużych modeli językowych wygląda tak samo: podaje się modelowi prompt i czeka, aż wygeneruje tekst.
Ale generowanie tekstu to tylko jeden ze sposobów wykorzystania modelu językowego.
Mały model można też wytrenować lub dostosować tak, by analizował stan, oceniał ograniczony zbiór możliwych akcji i wybierał jedną z nich. W tej roli model przestaje przypominać chatbota, a zaczyna przypominać silnik decyzyjny.
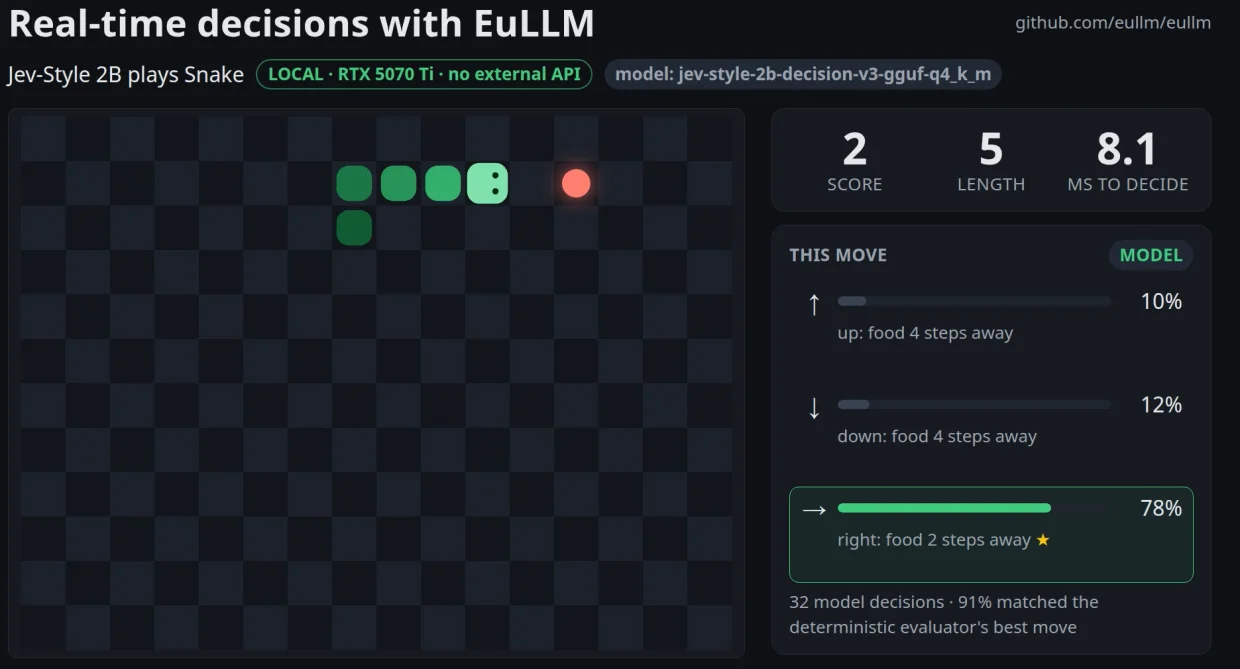
Zbudowaliśmy prostą demonstrację tego pomysłu, wykorzystując 2B Jev-style Decision Model działający lokalnie z EuLLM.
Zadanie jest celowo znajome: Snake.
Interesująca nie jest sama gra. Interesujące jest to, co dzieje się między dwoma ruchami.
Decyzja w około 8 milisekund
Na każdym kroku model otrzymuje aktualny stan gry i ocenia dostępne akcje.
Nie musi pisać eseju ani generować setek tokenów. Musi odpowiedzieć na znacznie węższe pytanie: co powinienem zrobić teraz?
Na NVIDIA RTX 5070 Ti model w naszym teście podejmuje tę decyzję w około 8 milisekund.
Całe wnioskowanie działa lokalnie przez EuLLM. Żadnego wywołania do zewnętrznego dostawcy modeli, żadnego zdalnego API w pętli decyzyjnej.
Demo zawiera też deterministyczny evaluator, który niezależnie oblicza najlepszą dostępną akcję na podstawie aktualnego stanu.
Na ponad tysiącu decyzji podczas jednego przebiegu około 95% wyborów modelu pokrywało się z najlepszym ruchem wskazanym przez evaluator.
To rozróżnienie ma znaczenie. Wynik 95% nie jest ogólnym „wskaźnikiem trafności" ani nie jest oceną jednego LLM przez drugi LLM-sędziego. Mierzy zgodność między decyzją modelu a deterministyczną implementacją referencyjną dla tego konkretnego zadania.
Dlaczego używać LLM do podejmowania decyzji?
Naturalne pytanie brzmi: po co używać modelu językowego do zadania, które można rozwiązać konwencjonalnym kodem?
W przypadku samego Snake'a nie ma przekonującego powodu. Snake to po prostu wizualne środowisko, w którym każdy natychmiast rozumie, czy decyzja była dobra, czy zła.
Interesujące zastosowania zaczynają się tam, gdzie stan trudniej jest opisać stałym zbiorem reguł.
Wyobraźmy sobie agenta enterprise, który pobrał dokumenty, przeanalizował zapytanie klienta i wywołał dwa narzędzia. Teraz musi ustalić, czy odpowiedzieć, pobrać więcej dowodów, wywołać kolejne narzędzie, czy eskalować zadanie do człowieka. To jest problem decyzyjny.
System bezpieczeństwa może musieć zdecydować, czy zdarzenie zignorować, skorelować z wcześniejszą aktywnością, zbadać, czy eskalować.
Pipeline RAG może musieć zdecydować, czy aktualnie pobrane dowody wystarczają do odpowiedzi na pytanie.
System przemysłowy może musieć wybrać kolejną akcję na podstawie telemetrii, warunków pracy i instrukcji tekstowych.
W każdym z tych przypadków wynik może być bardzo mały, nawet gdy dane wejściowe są złożone. To zmienia ekonomikę wnioskowania.
Małe modele nie zawsze muszą zachowywać się jak małe chatboty
Branża ma tendencję do oceniania małych modeli na podstawie tego, jak wiernie naśladują znacznie większe modele ogólnego przeznaczenia. To użyteczne, ale nie jedyny sposób ich wykorzystania.
Mały model można zamiast tego wyspecjalizować wokół wąskiej przestrzeni decyzyjnej. Jeśli wymagany wynik to jedna akcja spośród pięciu możliwości, generowanie kilku akapitów naturalnego języka to zbędny narzut.
Jest to szczególnie istotne dla lokalnej AI. Model 2B jest wystarczająco mały, by działać na powszechnie dostępnym sprzęcie, a jednocześnie wystarczająco duży, by interpretować dużo bogatsze dane wejściowe niż tradycyjny klasyfikator.
Użyteczne porównanie to więc nie zawsze mały model kontra duży model, ale czasem model wyspecjalizowany kontra zdalne wnioskowanie ogólnego przeznaczenia dla każdej pojedynczej decyzji.
Dla aplikacji podejmujących setki lub tysiące decyzji, opóźnienie i wymagania infrastrukturalne szybko stają się istotne.
Gdzie wpasowuje się EuLLM
EuLLM to nie model. To otwarta platforma zaprojektowana wokół lokalnej i europejskiej infrastruktury AI.
Projekt składa się z trzech uzupełniających się części.
EuLLM Engine dostarcza runtime używany do lokalnego uruchamiania modeli.
EuLLM Forge koncentruje się na specjalizacji modeli, wertykalizacji i przepływach pracy teacher-student.
EuLLM Hub jest rozwijany jako europejski rejestr modeli i warstwa dystrybucji, obejmująca informacje o modelach i zgodności.
Eksperyment ze Snake'em dotyczy głównie strony Engine: małego, skwantyzowanego modelu decyzyjnego działającego lokalnie i odpowiadającego z bardzo niskim opóźnieniem.
Ale ciekawsza jest kombinacja w dłuższej perspektywie. Większy model teacher może pomóc wytworzyć wyspecjalizowane mniejsze modele poprzez Forge. Te modele mogą następnie być uruchamiane przez Engine, blisko aplikacji, które z nich korzystają.
Jest to szczególnie atrakcyjne, gdy wnioskowanie musi pozostać prywatne, przewidywalne i tanie.
Modele decyzyjne i agenci AI
Jednym z najbardziej oczywistych zastosowań jest AI agentowa.
Dzisiejsi agenci często wysyłają stosunkowo proste decyzje kontrolne do dużych, zdalnych modeli:
- Czy agent powinien wyszukać ponownie?
- Które narzędzie powinien wywołać?
- Czy obecne dowody odpowiadają na pytanie użytkownika?
- Czy zadanie powinno zostać eskalowane?
Te decyzje często wymagają zrozumienia kontekstu, ale niekoniecznie wymagają bardzo dużego modelu generatywnego.
Mały lokalny model decyzyjny może potencjalnie działać jako część płaszczyzny sterowania, pozostawiając kosztowne wnioskowanie generatywne sytuacjom, w których jest ono naprawdę potrzebne.
Ta sama architektura może być zastosowana do pipeline'ów RAG. Retrieval nie musi być stałą sekwencją wyszukiwania, rerankingu i generowania. Model może ocenić jakość retrievalu i zdecydować, czy uzasadnione jest kolejne wyszukiwanie, czy należy odpytać inne źródło, czy pewność jest wystarczająca, by kontynuować.
I znów wynikiem jest decyzja, a nie dokument.
Lokalne wykonanie zmienia budżet opóźnień
Decyzja w 8 ms nie jest ważna tylko dlatego, że liczba jest mała. Zmienia to, które aplikacje są praktyczne.
Jeśli każdy krok zautomatyzowanego workflow wymaga zdalnego żądania HTTP do zewnętrznej usługi wnioskowania, opóźnienie się kumuluje. Zmienność sieci i dostępność usługi stają się częścią pętli sterowania.
Lokalne wnioskowanie eliminuje tę podróż w obie strony. Oznacza to również, że leżące u podstaw informacje nie muszą opuszczać maszyny uruchamiającej aplikację.
Dla środowisk enterprise te właściwości mogą być równie istotne jak sama jakość modelu.
Snake to wizualizacja, nie cel
Wybraliśmy Snake'a, ponieważ pętla decyzyjna jest widoczna. Można obserwować, jak model analizuje stan, wybiera akcję i natychmiast widać jej konsekwencję.
Ten sam mechanizm staje się wizualnie mniej efektowny — ale potencjalnie znacznie cenniejszy — gdy akcje są takimi rzeczami jak:
retrieve_morecall_toolapproveescalateroute_to_departmentinvestigate_eventcontinue_workflow
Właśnie wtedy małe modele decyzyjne stają się interesujące.
Eksperyment sugeruje szerszy kierunek dla EuLLM: lokalna infrastruktura AI nie musi być projektowana wyłącznie wokół uzupełniania czatu.
Czasem najbardziej użytecznym wynikiem, jaki może wyprodukować LLM, nie jest zdanie.
To kolejna akcja.
EuLLM jest open source: github.com/eullm/eullm
Projekt: eullm.eu